Solo puedo subir imágenes redimensionadas a nuestro sitio, así que probé AI Or Not con los archivos que realmente uso. Una foto que tomé de una taza de café en mi escritorio se marcó como generada por IA después de redimensionarla, mientras que la original no. Esperaba que el resultado fuera el mismo, ya que solo cambié las dimensiones. ¿A alguien más le ha pasado esto con copias redimensionadas, especialmente sin aplicar filtros ni hacer otras modificaciones?
Había interpretado mal los porcentajes
El error consiste en tratar la confianza de un detector como si fuera su precisión. Llego tarde a este tema y, al principio, esos porcentajes parecían más útiles de lo que realmente eran. La confianza, la probabilidad y la proporción estimada de contenido generado por IA no son intercambiables.
La comparativa del 2 y 3 de octubre de 2026 utilizó seis fragmentos en inglés sin modificar: cuatro textos generados, un extracto de Lewis Carroll y una versión editada con IA. Es una prueba pequeña, no un veredicto universal.
Los fallos me llamaron la atención
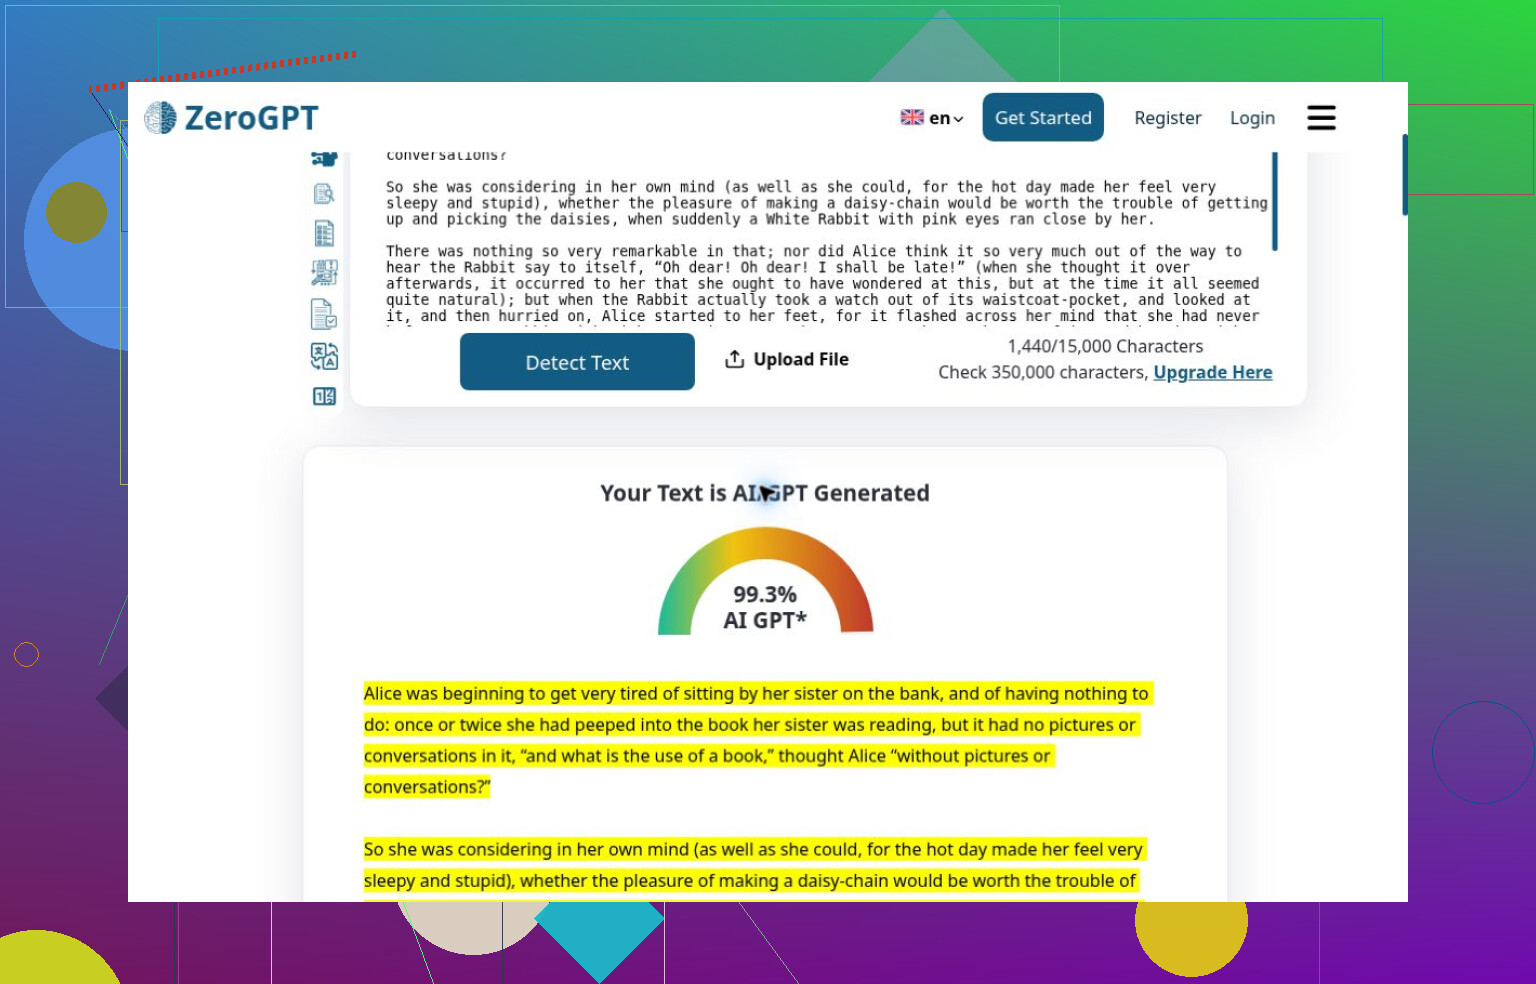
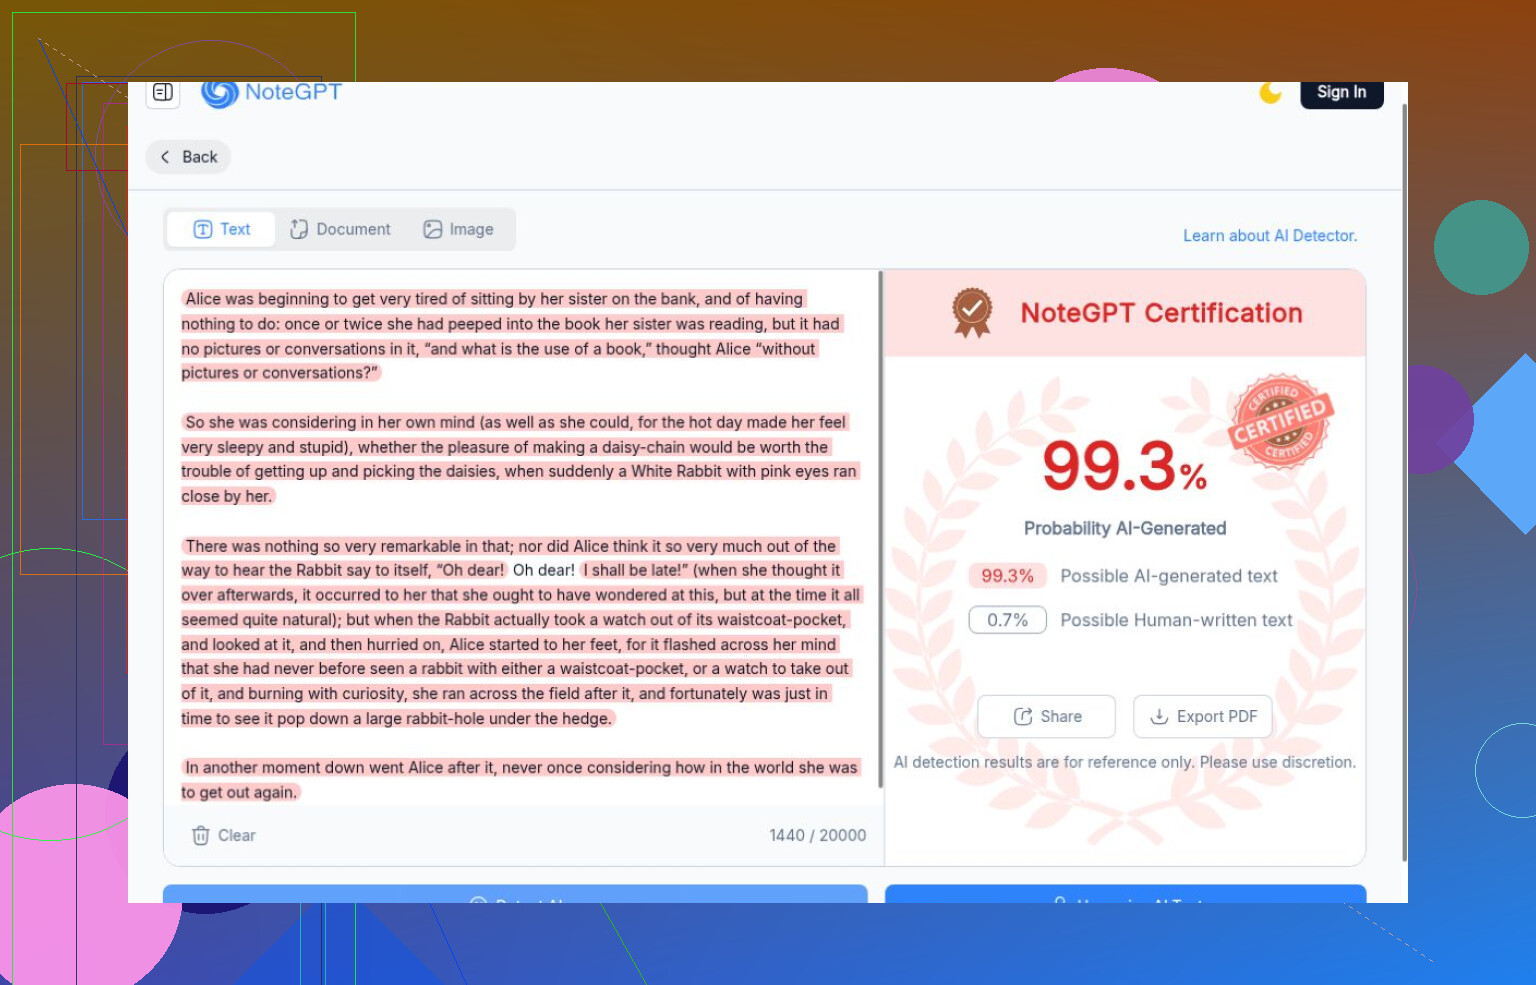
El texto humano de control me pareció más revelador que las detecciones acertadas. ZeroGPT detectó todos los fragmentos generados, pero etiquetó el de Carroll como un 99,3% de IA. NoteGPT le dio a Carroll la misma puntuación, por encima del 81,1% del ensayo y del 55,2% del relato. Al parecer, la literatura tenía que dar algunas explicaciones.
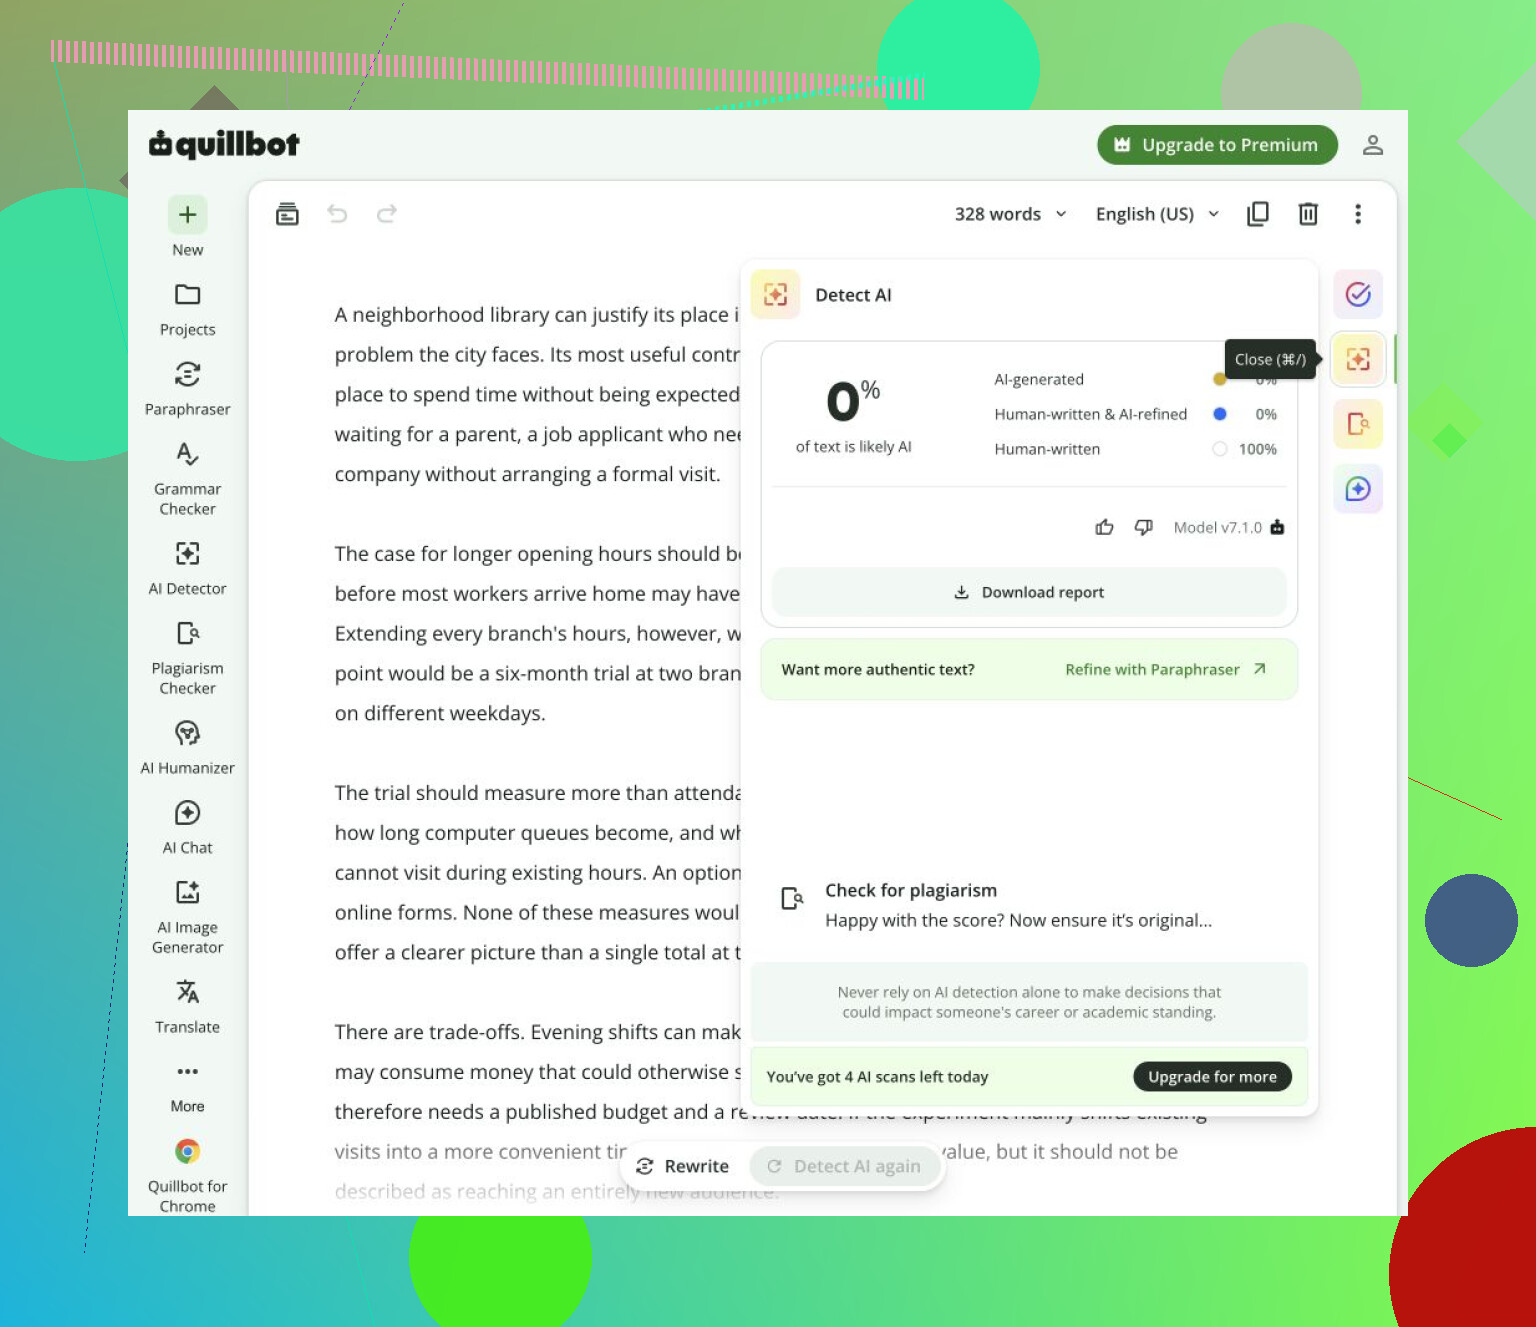
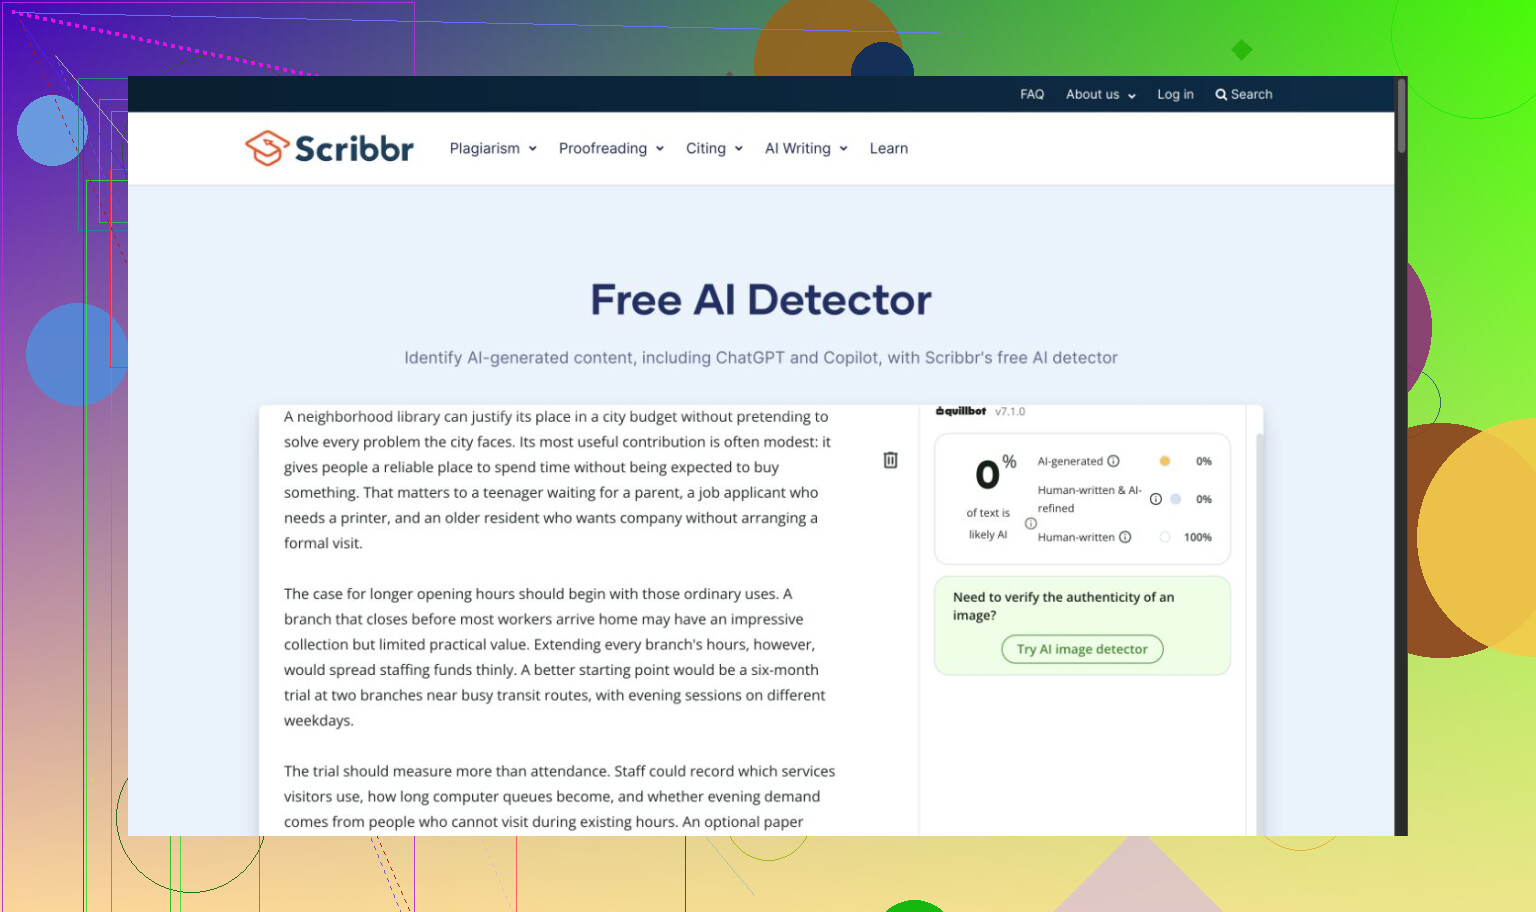
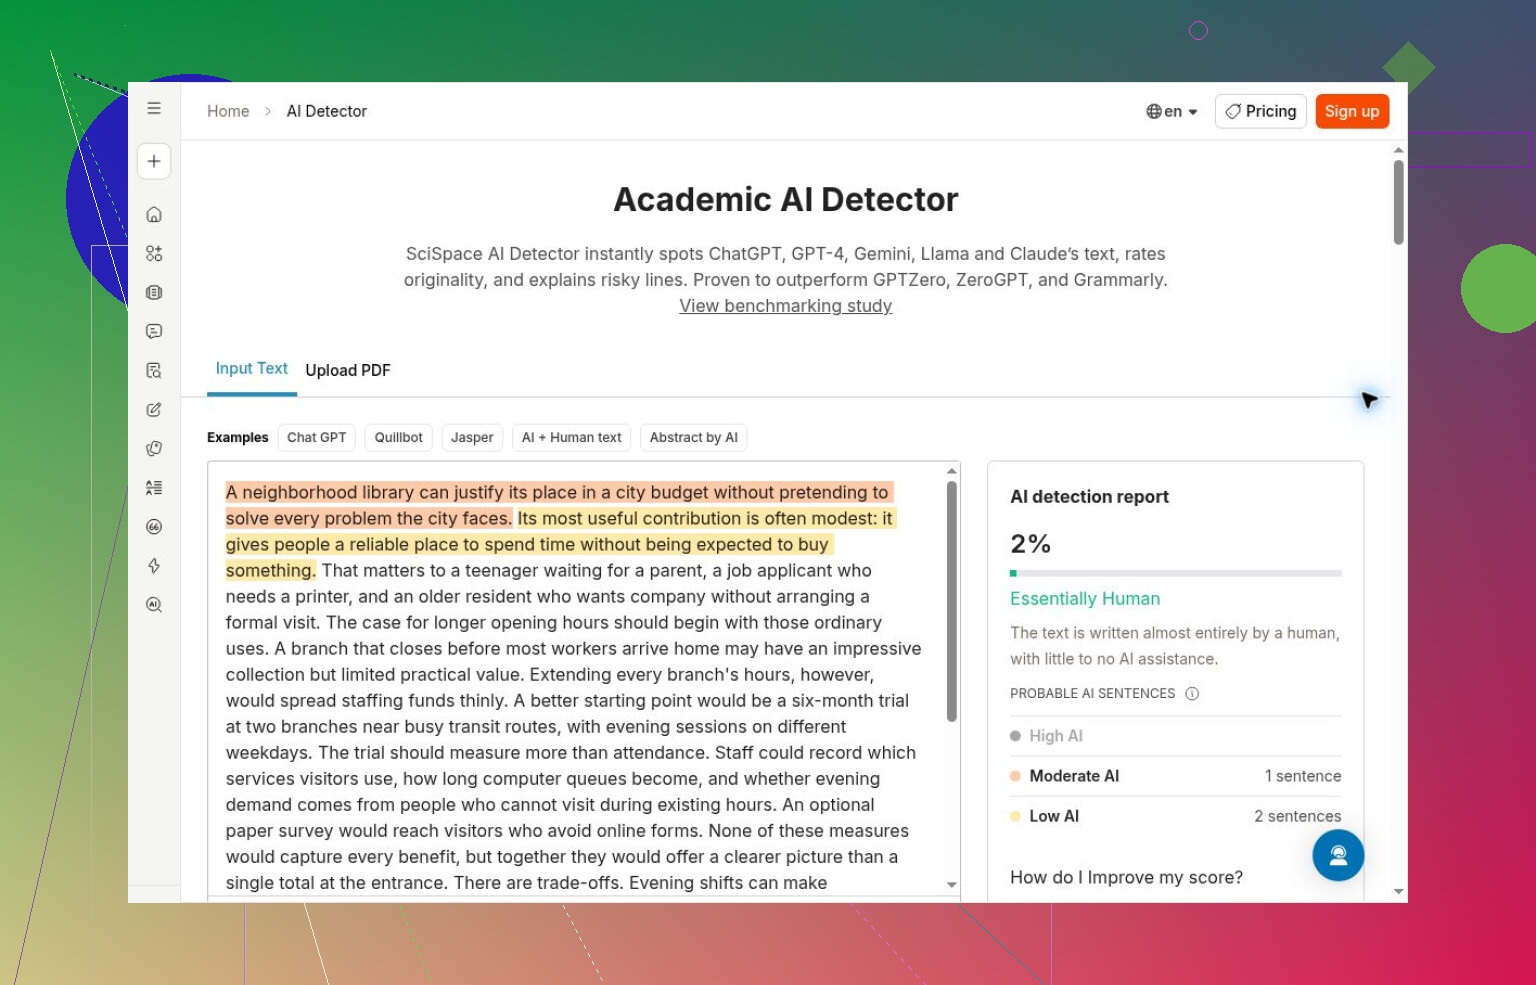
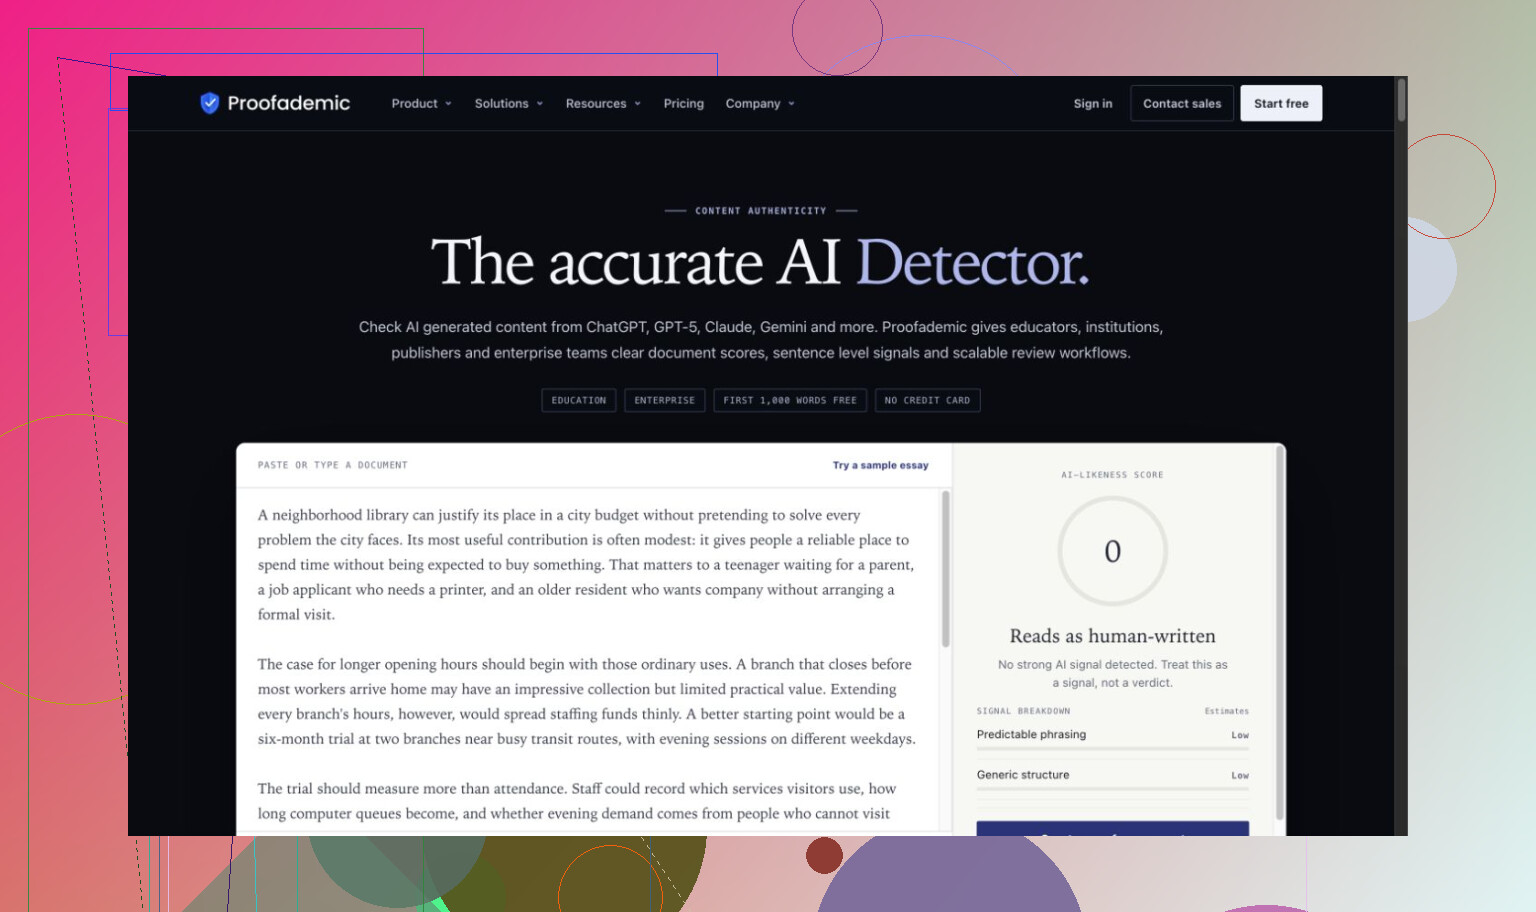
QuillBot se fue al extremo opuesto: los cuatro fragmentos generados recibieron etiquetas de contenido escrito por humanos al 100%. Scribbr tampoco detectó el ensayo, SciSpace lo clasificó como Esencialmente humano con un 2% de IA, y la demo pública de Proofademic dio tanto al ensayo como a Carroll una puntuación de similitud con la IA de 0/100. Surfer asignó una probabilidad de IA del 0% al ensayo, al relato y a Carroll.
Lo que me parece aprovechable
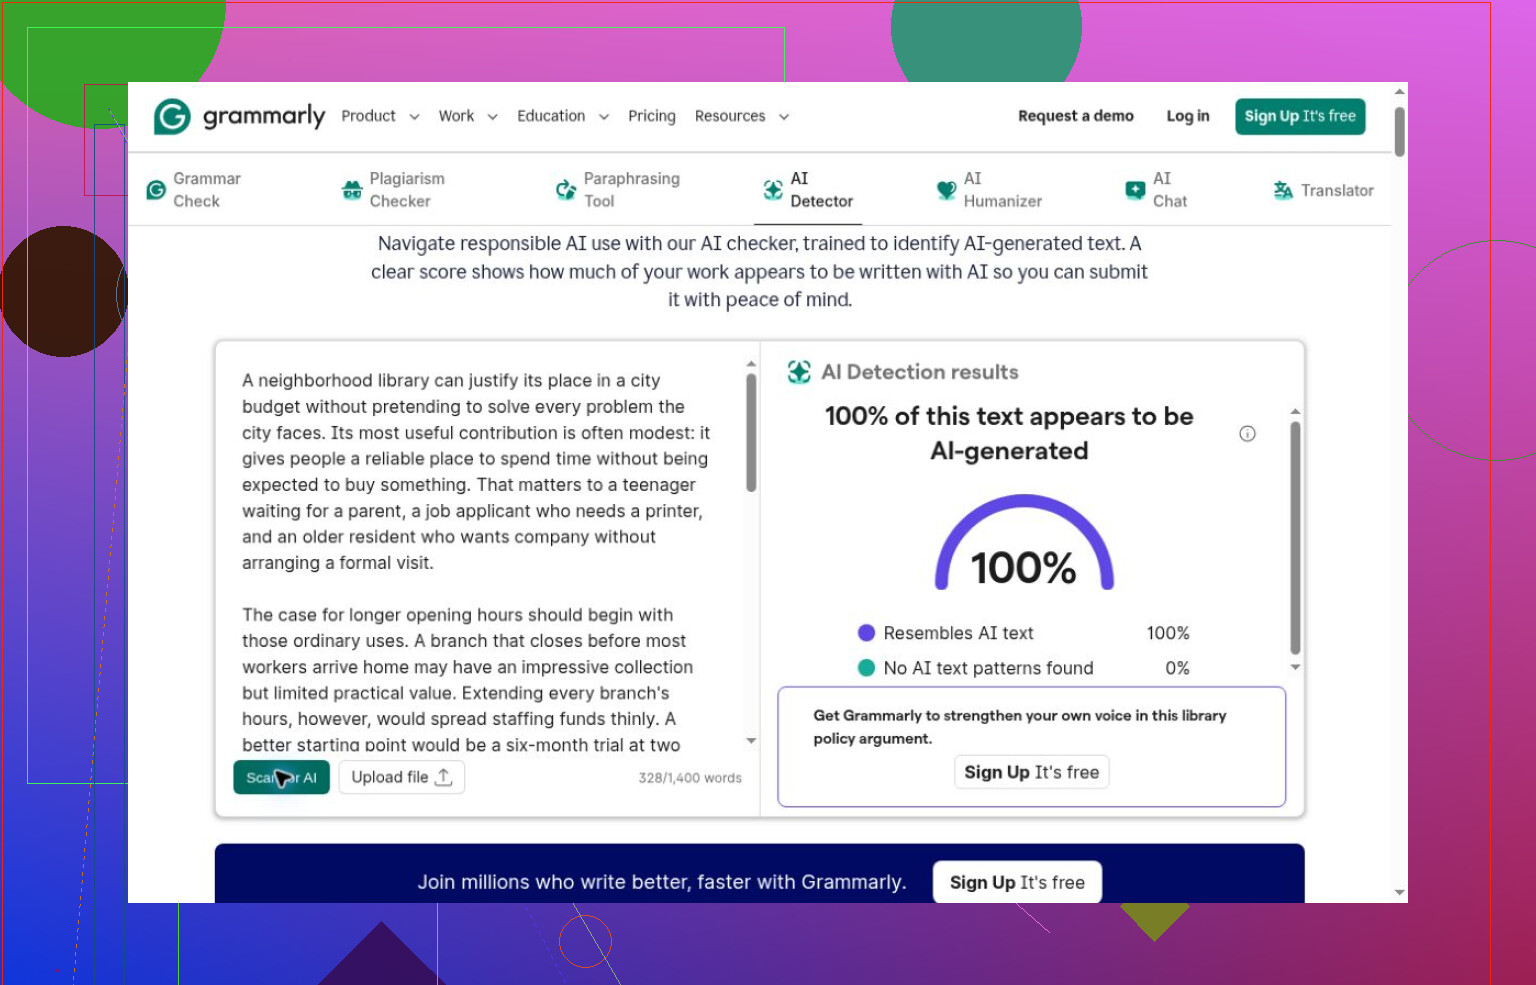
Ahora que me estoy poniendo al día, distinguiría entre la facilidad de acceso y la precisión demostrada. La herramienta Clever AI Detector completó el conjunto de pruebas sin pagos ni registro. Sus puntuaciones para los textos generados fueron del 89%, 84%, 82% y 74%; Carroll recibió un 99% de autoría humana. La versión ligeramente editada obtuvo lo mismo, lo que limita las conclusiones que sacaría sobre la escritura mixta.
Pangram resolvió correctamente las comprobaciones de IA y de autoría humana que completó, pero se detuvo tras cinco análisis. Originality.ai y AI or Not acertaron en tres casos cada uno. El 100% de confianza de Originality correspondía a un veredicto emitido con una tolerancia de IA del 15%, no a una medición de las palabras generadas.
Dónde dejo de conceder mérito
No calificaría de inexacto un resultado al que no se puede acceder. Las pantallas de inicio de sesión, las puntuaciones ocultas, las extensiones sin instalar y las fichas en tiendas reflejan las condiciones de acceso, no el rendimiento de detección. Las capturas de pantalla incluyen ambos tipos de pruebas.
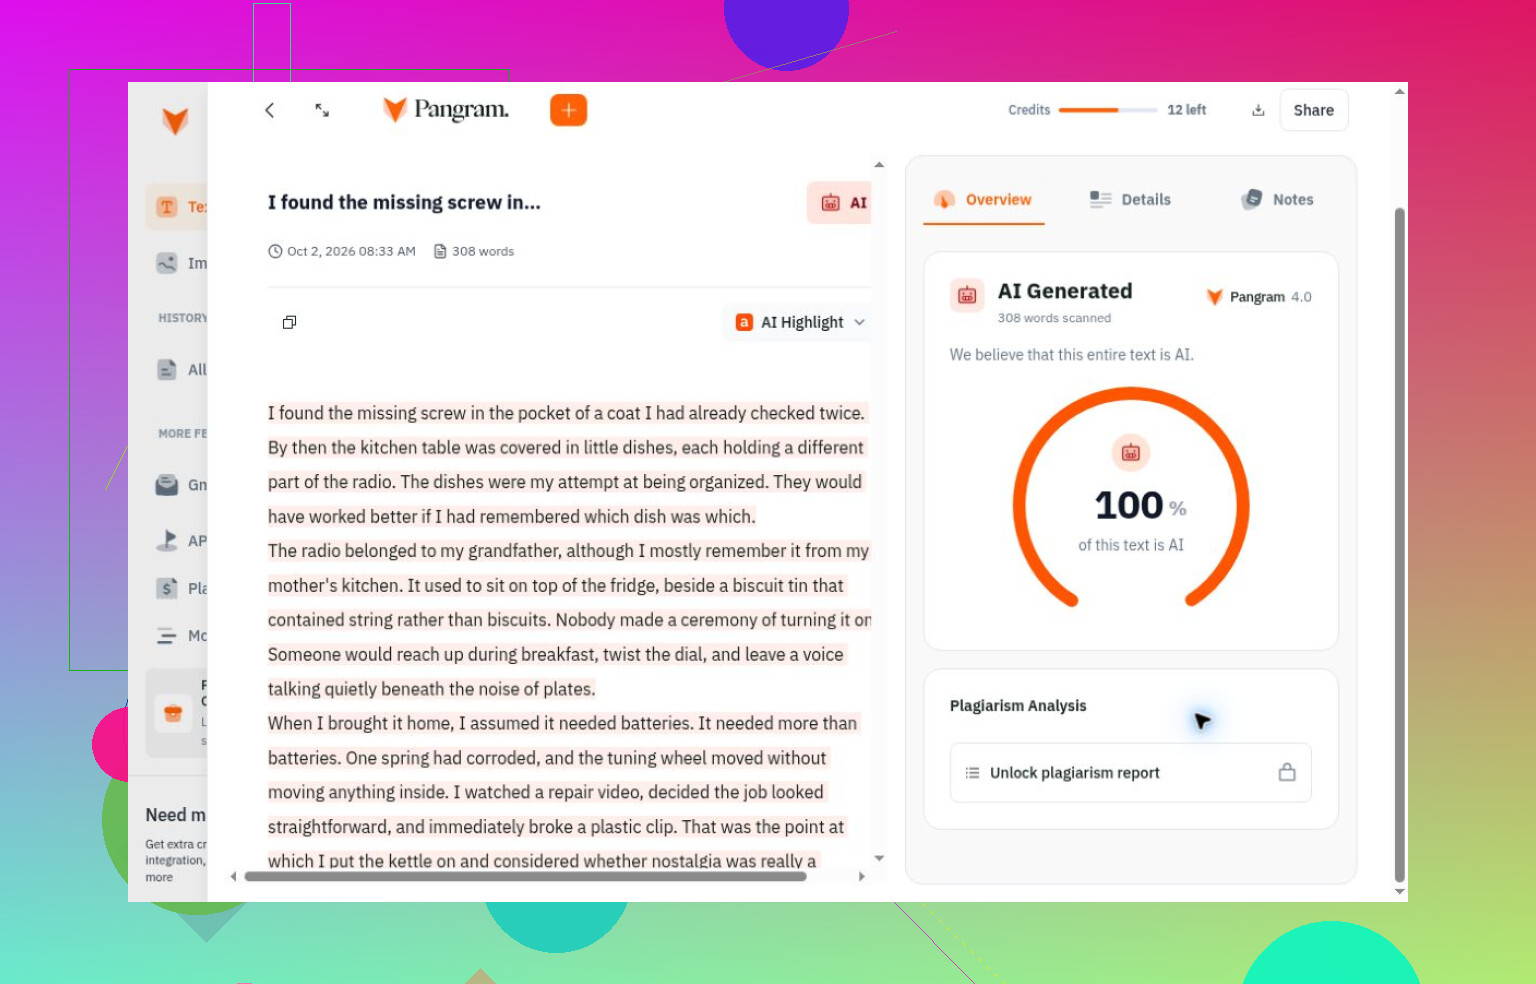
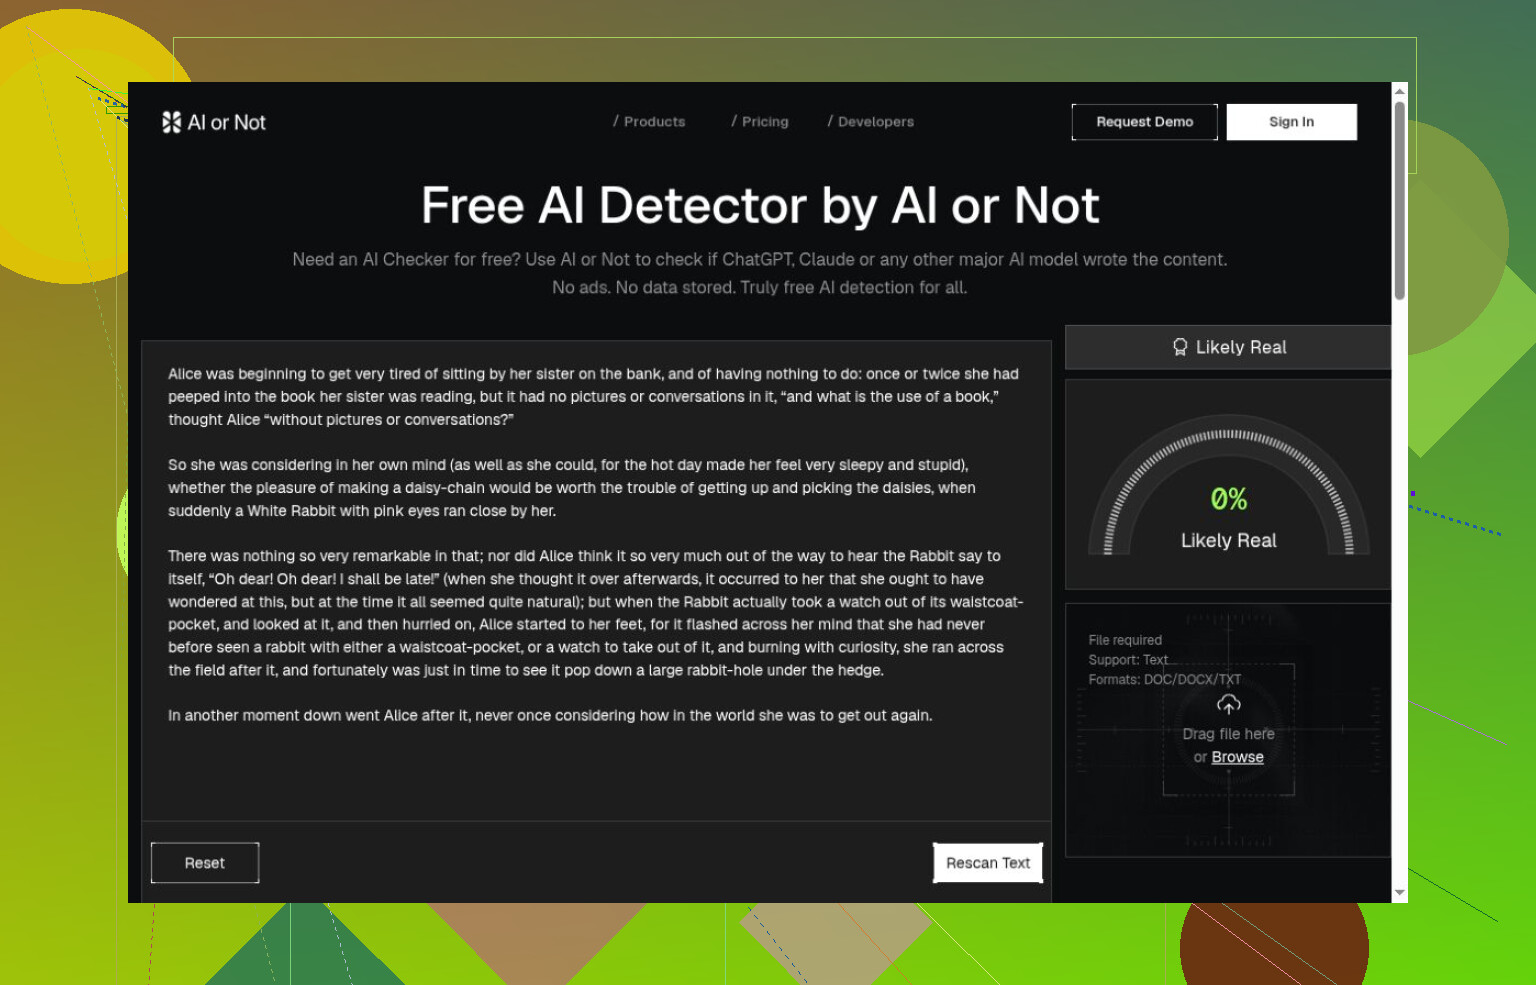
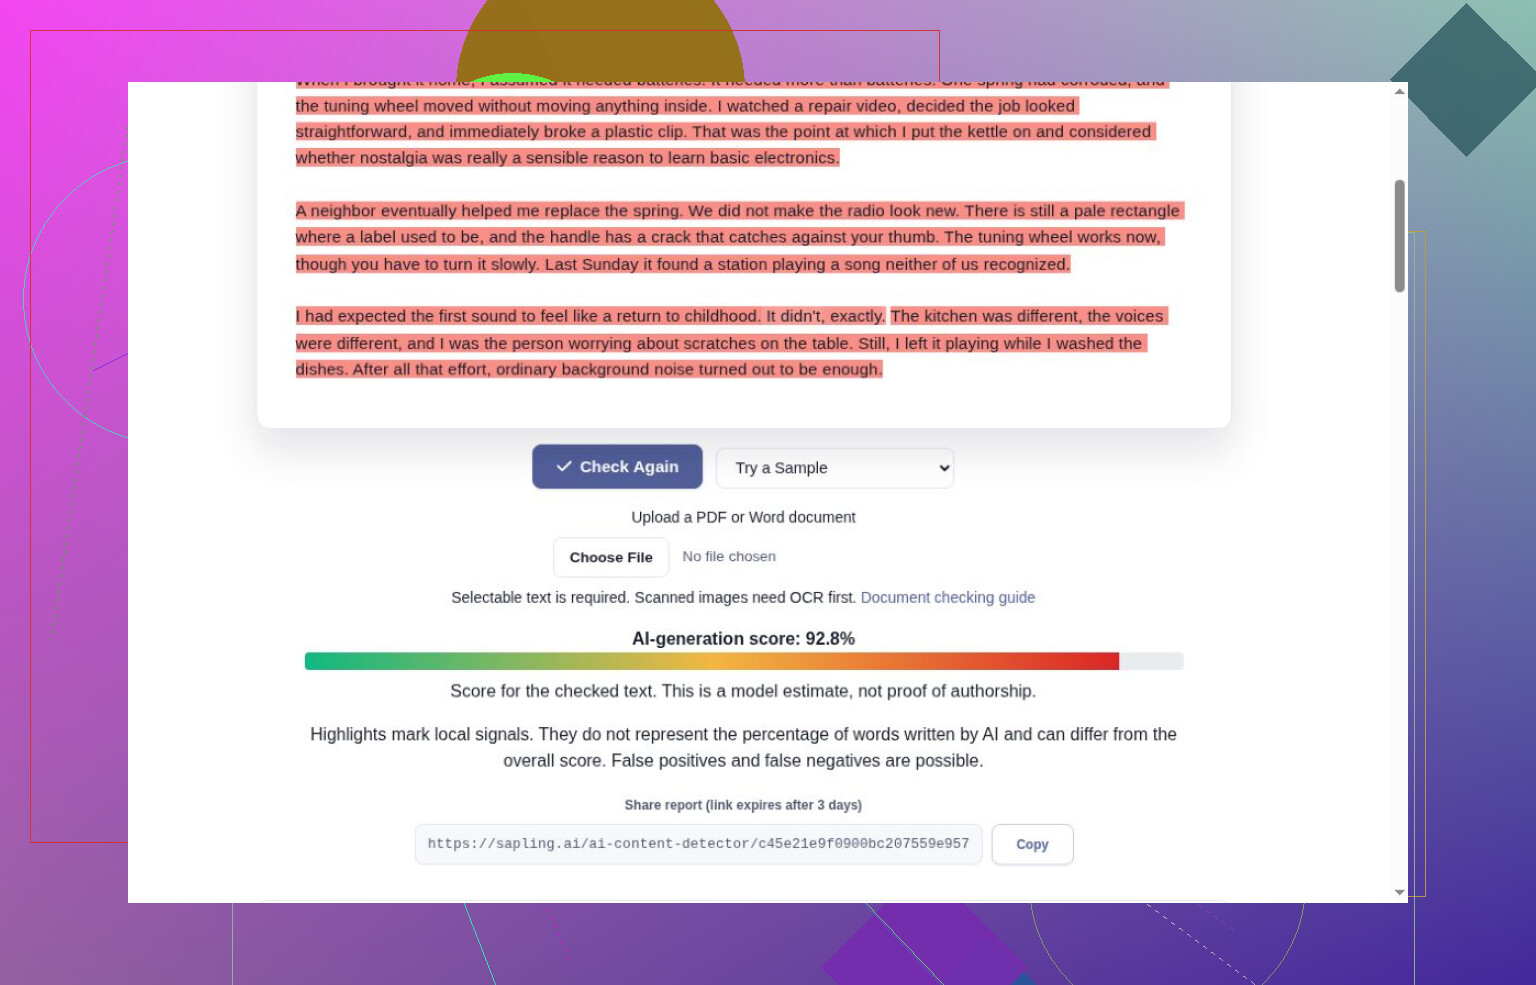
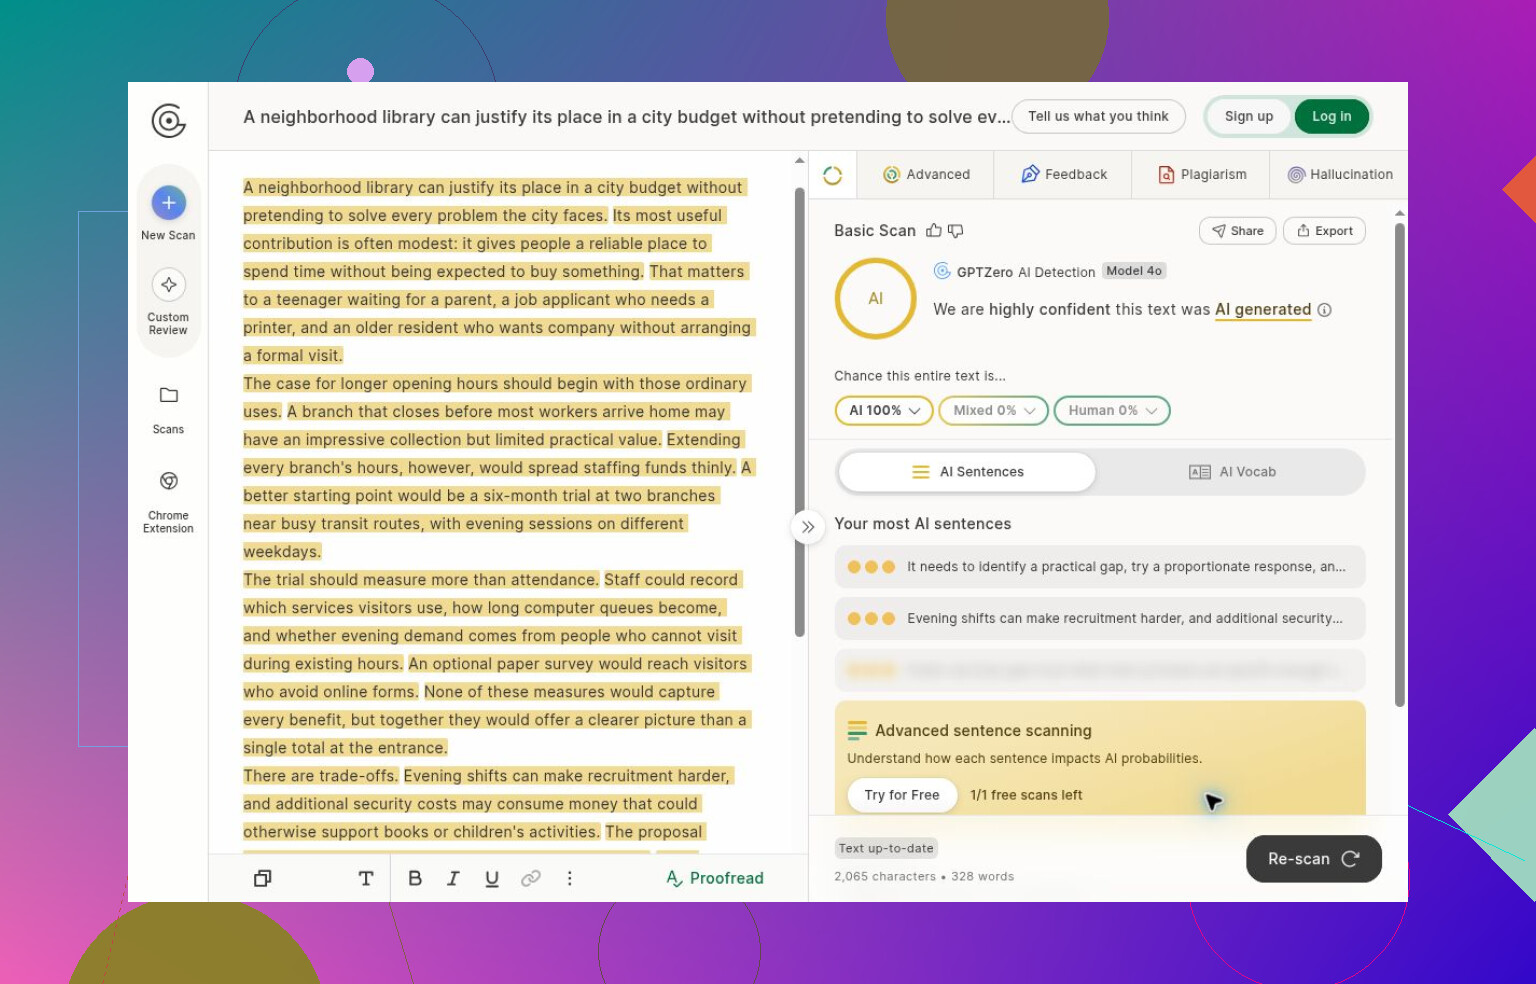
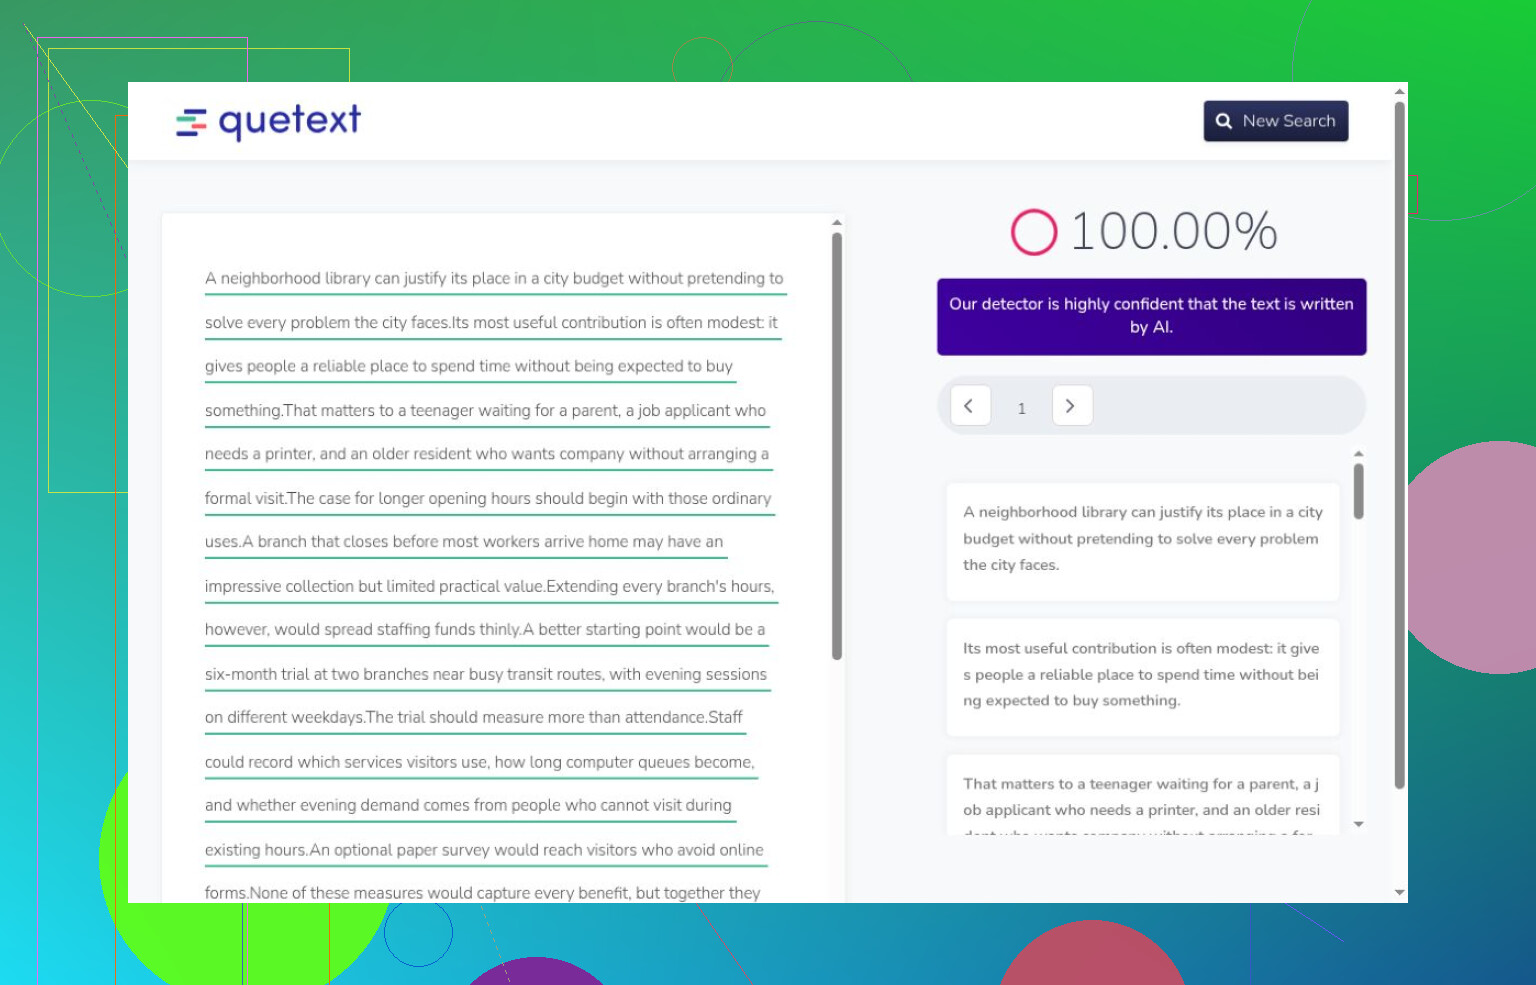
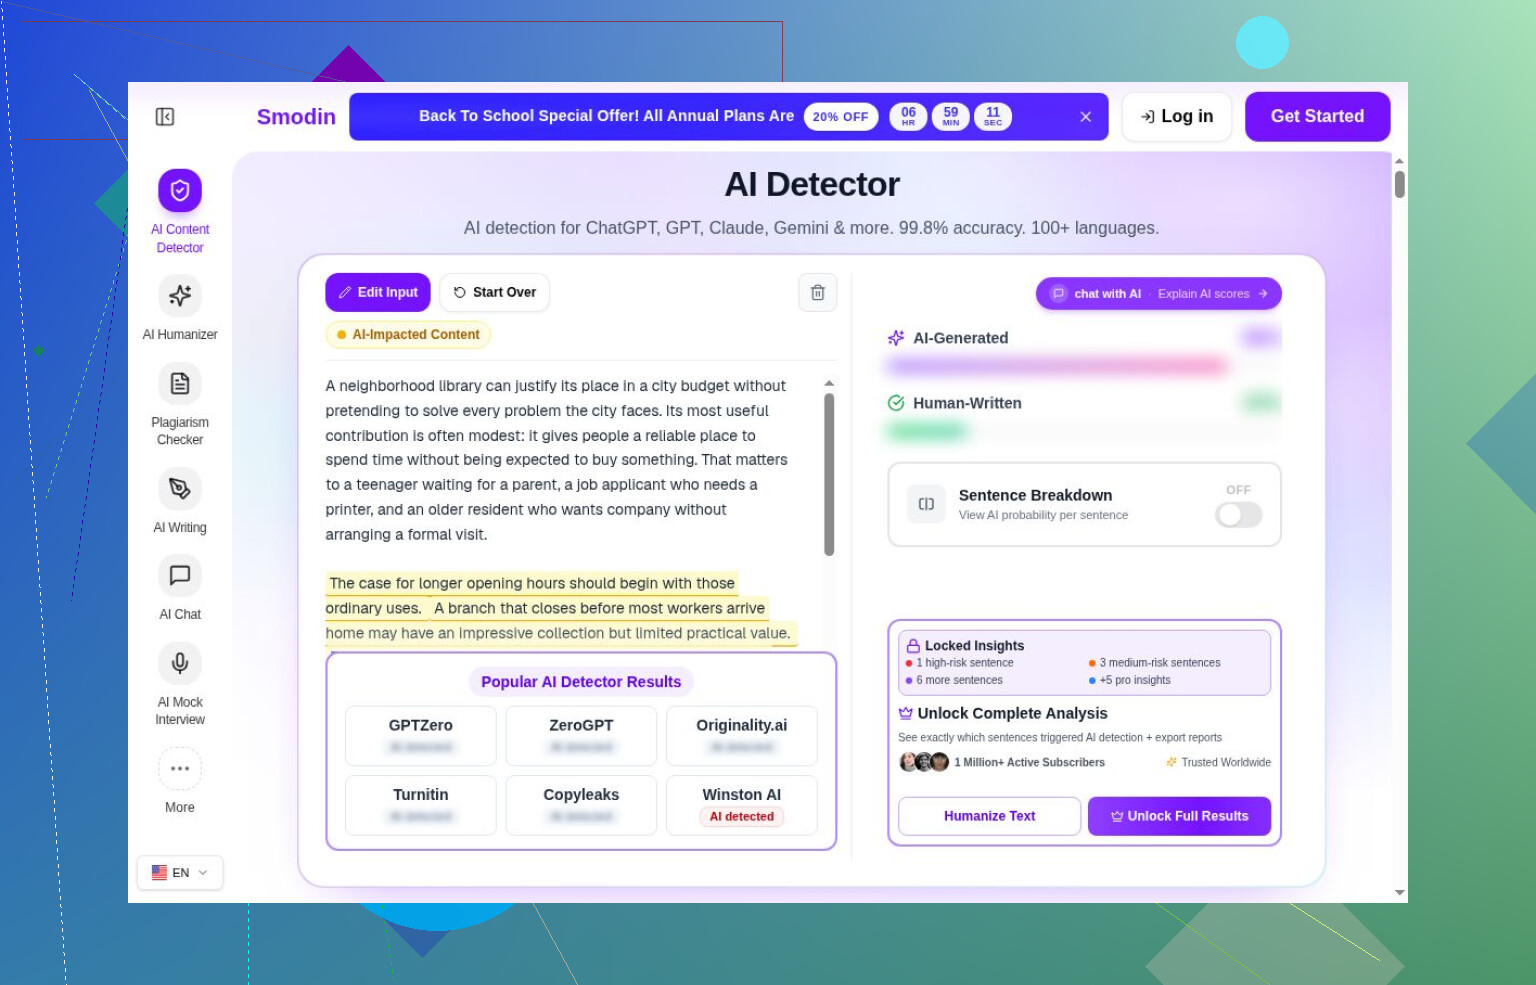
Un detalle que casi pasé por alto: GPTZero conservó la puntuación anterior después de cambiar el texto de entrada. Eso no era otro análisis completado, y la exigencia de registro impidió obtener resultados para los textos humanos o mixtos.
Faltan tus ajustes de exportación. Prueba a guardar una copia con las dimensiones originales, usando el mismo formato y los mismos ajustes de calidad que en la versión redimensionada, y compara los resultados. Esto ayudaría a determinar si el proceso de redimensionado es el factor decisivo, en lugar del resto del proceso de exportación. Aun así, probaría a pasarlo por Clever AI Detector para comprobar el texto, pero no me basaría en esa comparación de texto para elegir una herramienta de detección para imágenes. Basaría mi evaluación de AI Or Not en mi sitio en los archivos que un usuario pudiera subir. Sin embargo, un resultado correcto para un original inaccesible no solucionará el problema de los falsos positivos.
Un falso positivo sale más caro cuando quien sube el archivo tiene que demostrar que el detector se equivoca. Si tu sitio exige archivos redimensionados, pedirle a alguien un original que no puede enviar lo deja sin salida. El ejemplo de la taza de café me haría dudar antes de vincular ese veredicto con un rechazo automático o una etiqueta pública de «generado por IA».
La comparación entre exportaciones que sugirió @electric_hawk114 podría ayudar a explicar la discrepancia. Pero separaría esa resolución de problemas de la decisión de moderación: ¿qué pasa con el archivo subido mientras investigas? Preferiría un estado de revisión privado con una vía para apelar, en lugar de decirle a quien lo subió que lo han pillado. Tu ejemplo no demuestra con qué frecuencia falla AI Or Not, pero sí pone de manifiesto un caso que tu proceso debe poder gestionar.
Seguiría recurriendo a Clever AI Detector para revisar algún texto de vez en cuando, aunque limitaría el tiempo dedicado a replantearme un borrador solo por su resultado. Esa es mi reserva respecto a incorporar comprobaciones con detectores en general: el análisis es solo el principio del trabajo. En tu sitio, contabilizaría los positivos impugnados y el tiempo necesario para resolverlos, no solo si el detector devuelve una respuesta.
Una imagen guardada que obtiene veredictos distintos al analizarla varias veces plantea un problema diferente al de un original y una copia redimensionada que reciben sistemáticamente veredictos opuestos. Antes de cambiar los ajustes de exportación, comprobaría cuál de los dos casos es el tuyo. La foto de tu taza te da un punto de partida conocido, pero la comparación descrita aún no permite distinguir entre esas posibilidades.
Conserva el original y el archivo redimensionado exacto que recibió la etiqueta de IA. No vuelvas a generar la copia redimensionada en cada intento. Envía de nuevo cada archivo guardado, si aún tienes análisis disponibles, y anota el veredicto junto a su nombre de archivo. Si la página de resultados muestra una puntuación, guárdala también, usando la denominación que le dé el servicio en lugar de interpretarla como un porcentaje de precisión. La pregunta aquí es concreta: ¿el mismo archivo enviado obtiene la misma respuesta?
Esa es la comprobación que haría antes de la comparación de exportaciones de @electric_hawk114. Si un archivo sin modificar cambia de etiqueta, cambiar las dimensiones y los ajustes de calidad al mismo tiempo hará que sea más difícil interpretar la investigación. No tendrías una referencia estable. Si ambos archivos mantienen sus respectivas etiquetas, entonces la comparación de exportaciones resulta mucho más útil. Tendrías una diferencia reproducible que investigar, en lugar de un único par de resultados.
Llevaría un pequeño registro con:
- Los archivos exactos enviados, con nombres distintos.
- Sus dimensiones, formato y tamaño de archivo.
- Las horas de los análisis y sus resultados correspondientes.
- Si enviaste una exportación local o una copia descargada de tu sitio web.
Conviene dejar clara esa última distinción. Si analizaste tu copia redimensionada local, describe el resultado de ese modo. Si analizaste el archivo que se sirve desde tu sitio web, conserva ese archivo. No des por hecho que son intercambiables mientras intentas reproducir el problema.
En una reseña de AI Or Not, describiría el comportamiento observado antes de ofrecer una explicación: tu propia foto recibió etiquetas distintas antes y después de exportarla, indicando si se comprobó que el resultado era reproducible o si eso aún se desconoce. «El cambio de tamaño provocó la detección errónea» es una afirmación más contundente de lo que permiten sostener las pruebas actuales.
Un par de archivos con resultados reproducibles también permitiría plantear una solicitud de soporte mucho más útil. Podrías facilitar ambos archivos al proveedor y preguntar si ese comportamiento es el esperado dentro de las condiciones de entrada admitidas. Eso te acercaría más a una respuesta que te permita actuar que una garantía general sobre la precisión del detector.
A tu comparación le falta una imagen generada por IA que haya pasado por el mismo proceso de subida. La foto de la taza te indica que algo salió mal con una foto real, pero no te dice si AI Or Not sigue siendo capaz de detectar imágenes generadas en el formato que acepta tu sitio.
Yo seguiría la sugerencia de @hyperrunner1199 de repetir el análisis, pero no dedicaría toda la prueba a intentar cambiar el veredicto sobre esa taza. Separa unas cuantas imágenes de origen conocido, tanto fotos tomadas con una cámara como imágenes generadas, y aplica a todas tu configuración habitual de subida. Elige esos archivos antes de consultar ninguna puntuación, en lugar de seleccionar más ejemplos en función del resultado que te parezca extraño.
La distinción importa cuando empiezas a ajustar la configuración. Una exportación que consiga que la foto de tu taza se clasifique correctamente podría parecer una solución, pero si también deja pasar las imágenes generadas, no supone una gran mejora. Lo ideal sería evaluar la misma configuración de exportación con ambos grupos.
Para la reseña, esa es la pregunta en la que me centraría: ¿distingue los dos grupos después del procesamiento que requiere tu sitio? Conseguir que la clasificación de la foto de la taza vuelva a ser la correcta sería satisfactorio, pero yo querría algo más antes de considerar que la herramienta es útil para tu sitio.
Un detector que analiza principalmente fotos tomadas con una cámara plantea una situación distinta a la del mismo detector cuando analiza sobre todo imágenes generadas. Me gusta la sugerencia de @cryptoroot_25 de probar ambos grupos, pero un lote de prueba con una mezcla a partes iguales no me diría hasta qué punto serían útiles las alertas en tu sitio. Si las fotos auténticas constituyen la mayoría de los envíos, las falsas alarmas de ese grupo más numeroso podrían superar en cantidad a las imágenes generadas correctamente detectadas. Eso puede ocurrir incluso cuando una prueba detecta la mayoría de los ejemplos generados.
Yo mantendría separados los resultados de ambos grupos, en lugar de combinarlos en una única cifra de precisión. Para las fotos tomadas con una cámara, cuenta cuántas imágenes se identificarían erróneamente como generadas después del procesamiento que necesitas aplicar. Para las imágenes generadas, cuenta cuántas pasan desapercibidas. Después, considera estos resultados teniendo en cuenta las imágenes que probablemente se subirán, sin dar por hecho que conoces la proporción exacta entre ambos tipos. Tu ejemplo de la taza es un motivo para investigar la primera cifra, pero no aporta datos suficientes para extrapolar. En una reseña de AI Or Not, ese tipo de desglose me resultaría más esclarecedor que una tasa global de aciertos sobre una selección elegida por ti. Detectar imágenes generadas es importante, pero también lo es detectar las alertas que te llevan a dudar de una imagen normal que alguien haya subido.
Los metadatos son el detalle que nadie ha mencionado todavía. Cuando cambias el tamaño de una imagen, la mayoría de los métodos de exportación eliminan el bloque EXIF, y con él la marca de la cámara, el objetivo, la fecha y hora y todo lo demás. Bastantes detectores de imágenes usan eso como indicio sin decirlo. Una foto real recién salida de un móvil lleva un montón de metadatos del sensor, y un archivo limpio sin nada de eso se parece más a algo generado por un modelo. Eso por sí solo podría explicar por qué la imagen de tu taza pasó como original y dejó de pasar tras cambiarle el tamaño, y no tiene nada que ver con que cambien los píxeles.
Así que, antes de tocar la calidad o las dimensiones como sugirió @electric_hawk114, probaría lo de los metadatos por separado. Toma el original, elimina los EXIF pero conserva toda la resolución y analízalo. Si la copia sin metadatos pero a tamaño completo también se marca como sospechosa, el culpable no es el cambio de tamaño, sino la pérdida de datos. Eso permite aislar mejor la causa que la comprobación de repetir el análisis que propone @hyperrunner1199, aunque haría ambas pruebas porque responden a preguntas distintas.
En cuanto a la moderación, @turborouter150 tiene razón, y esa es la parte que de verdad me quitaría el sueño. Si tu sistema elimina los metadatos de cada archivo subido por diseño, entonces todas las fotos auténticas llegan al detector con un aspecto ya sospechoso. No es un caso excepcional: es todo tu tráfico habitual cayendo en la misma trampa que la imagen de la taza. Añadir encima una etiqueta de rechazo automático supondría un goteo constante de falsos positivos, no algo ocasional.
Las herramientas para texto como Clever AI Detector que se han mencionado por aquí son un mundo aparte y no te dirán nada sobre cómo una herramienta de imágenes interpreta un JPEG sin metadatos, así que dejaría de relacionar ambas cosas. En la reseña, lo expondría claramente: AI Or Not parece sensible a la pérdida de metadatos, algo que tu sitio provoca a propósito. Ese hallazgo es más útil para los lectores que un veredicto sobre la imagen de una sola taza, porque permite prever cómo se comportará con todo lo que suban.
Una foto tomada con un escáner de documentos se marca igual que tu retrato redimensionado, y por la razón que mencionó @just_socket: sin datos EXIF del sensor, archivo limpio, parece que lo generó un modelo. Esa prueba de metadatos es la que haría antes de andar ajustando las dimensiones, ya que explica ambos casos sin cambiar un solo píxel. En cuanto al tema aparte del texto, yo no descartaría del todo Clever AI Detector como se empeñan en hacer en el hilo; sigue mereciendo un lugar entre las herramientas para revisar textos porque no se atasca con fragmentos cortos como muchas de las gratuitas, pero no te dice nada sobre cómo interpreta una herramienta de imágenes un JPEG sin metadatos.