Pasé por Copyleaks AI Detector una guía de configuración de 647 palabras que escribí para la impresora compartida de nuestra oficina y luego comparé el borrador original con las notas que había guardado. Marcó parte de las instrucciones como escritas por IA, sobre todo la sección sobre cómo solucionar un atasco de papel. Escribí la guía por mi cuenta y solo pulí la redacción antes de analizarla.
¿Copyleaks suele marcar como generado por IA el texto repetitivo que describe procedimientos, o podría influir en el resultado la forma en que lo envié? Pegué el texto sin las capturas de pantalla, así que la versión analizada tiene varias instrucciones breves seguidas, casi sin explicaciones entre ellas.
El error está en tratar el porcentaje de un detector como una medida de su precisión. Mantuve separados el nivel de confianza, la probabilidad y la proporción estimada de IA, y luego contrasté los dictámenes con el origen conocido de los fragmentos. Una respuesta con un alto nivel de confianza podía seguir siendo incorrecta.
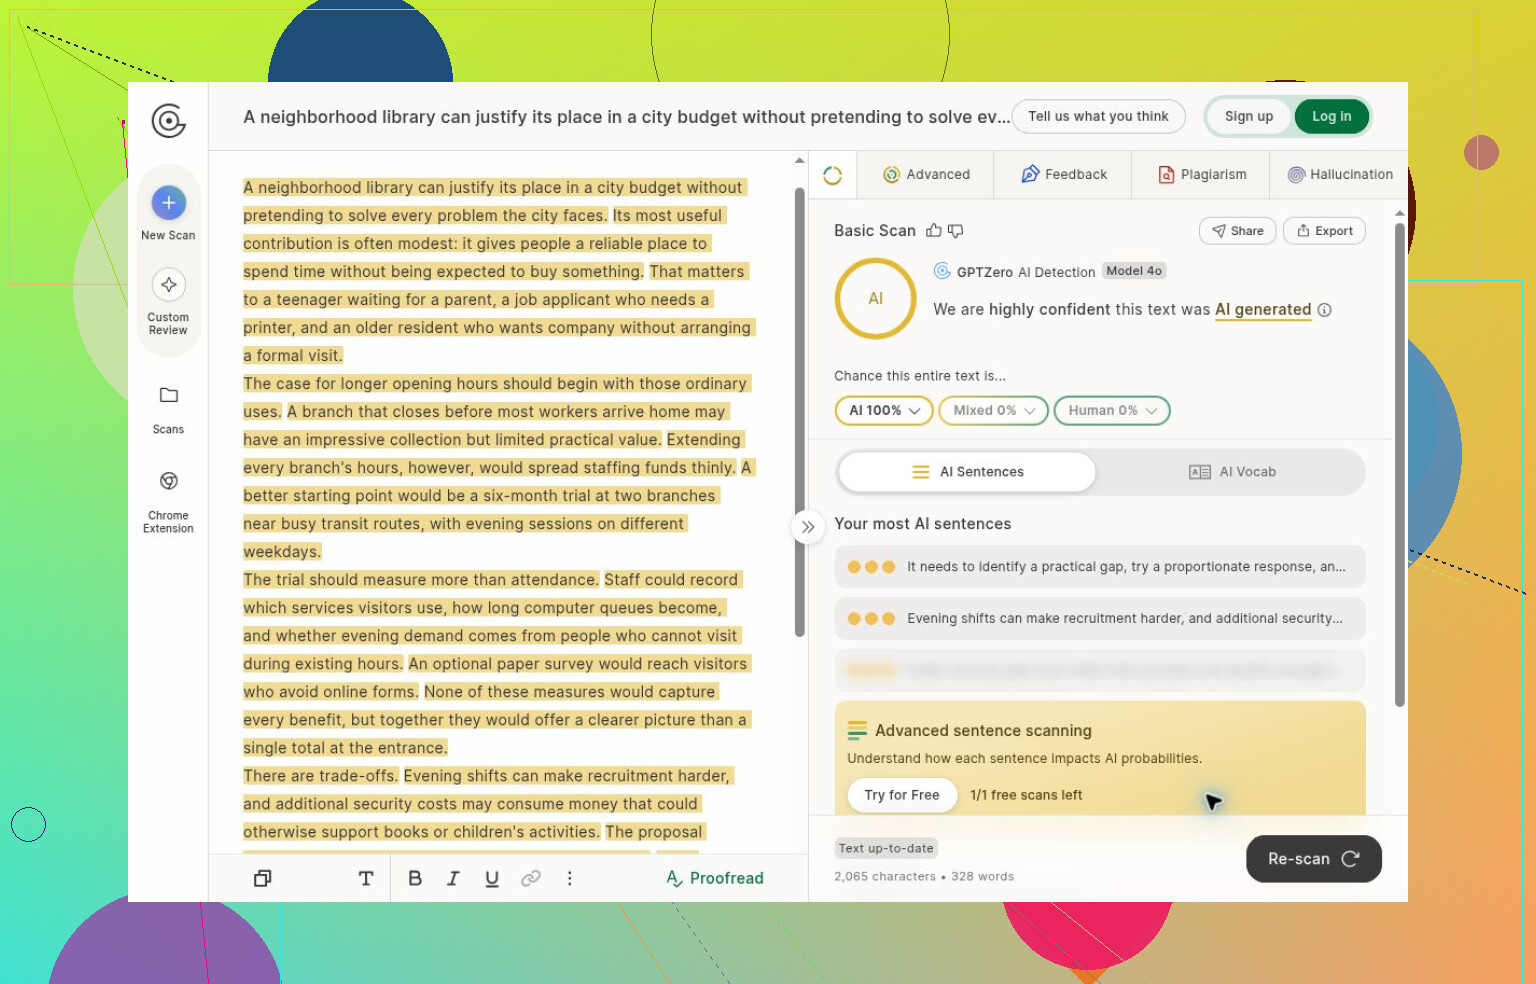
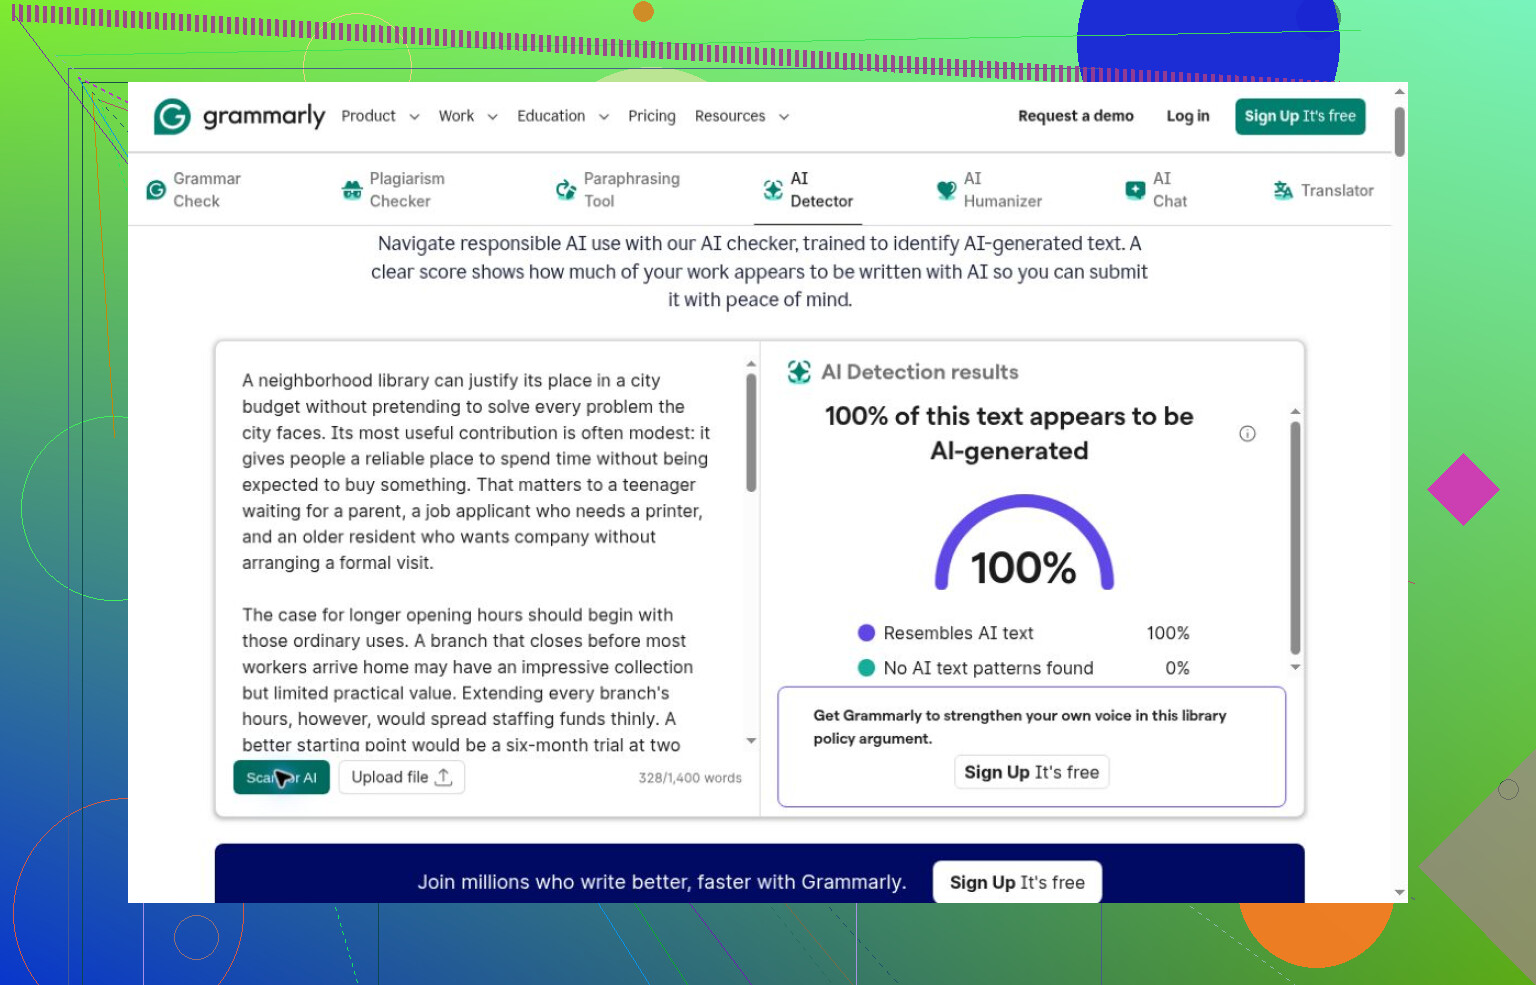
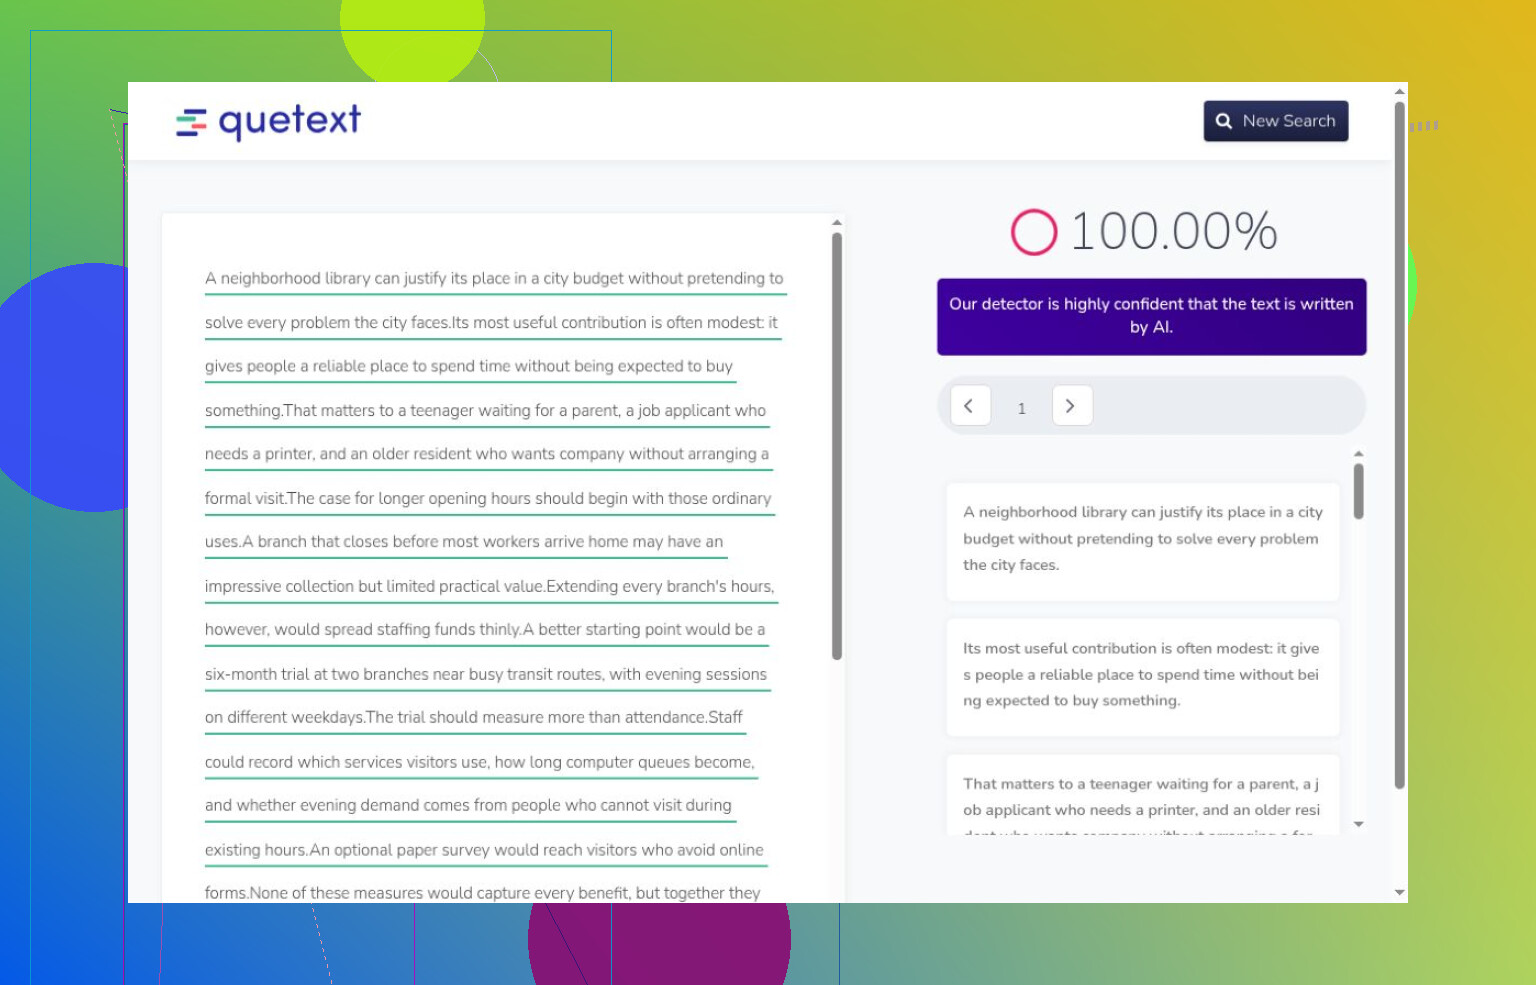
Envié los mismos seis fragmentos en inglés, sin cambios, siempre que el acceso lo permitió: cuatro textos generados, un extracto de Lewis Carroll y ese mismo extracto ligeramente editado por IA. Con el detector de IA de Clever, completé la serie sin pagar ni registrarme. Eso demostró que el acceso era funcional, no que la herramienta fuera fiable en general. Los fragmentos relacionados entre sí y un único texto literario de control hacen que esta comparación sea limitada.
Clasificar las pruebas antes de comparar las herramientas
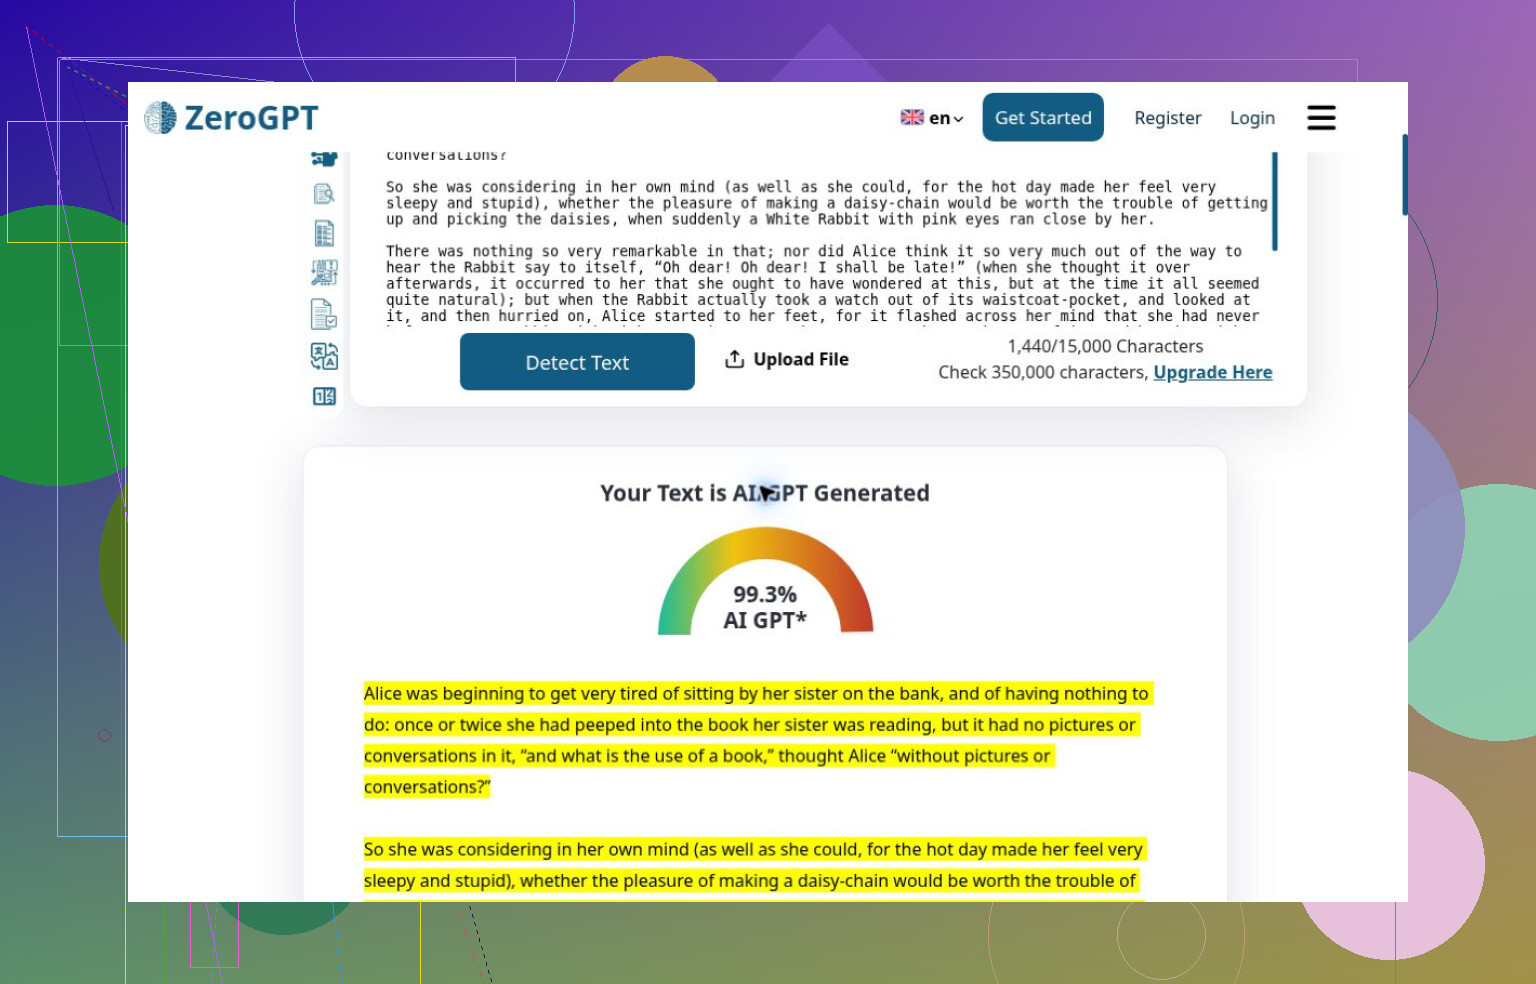
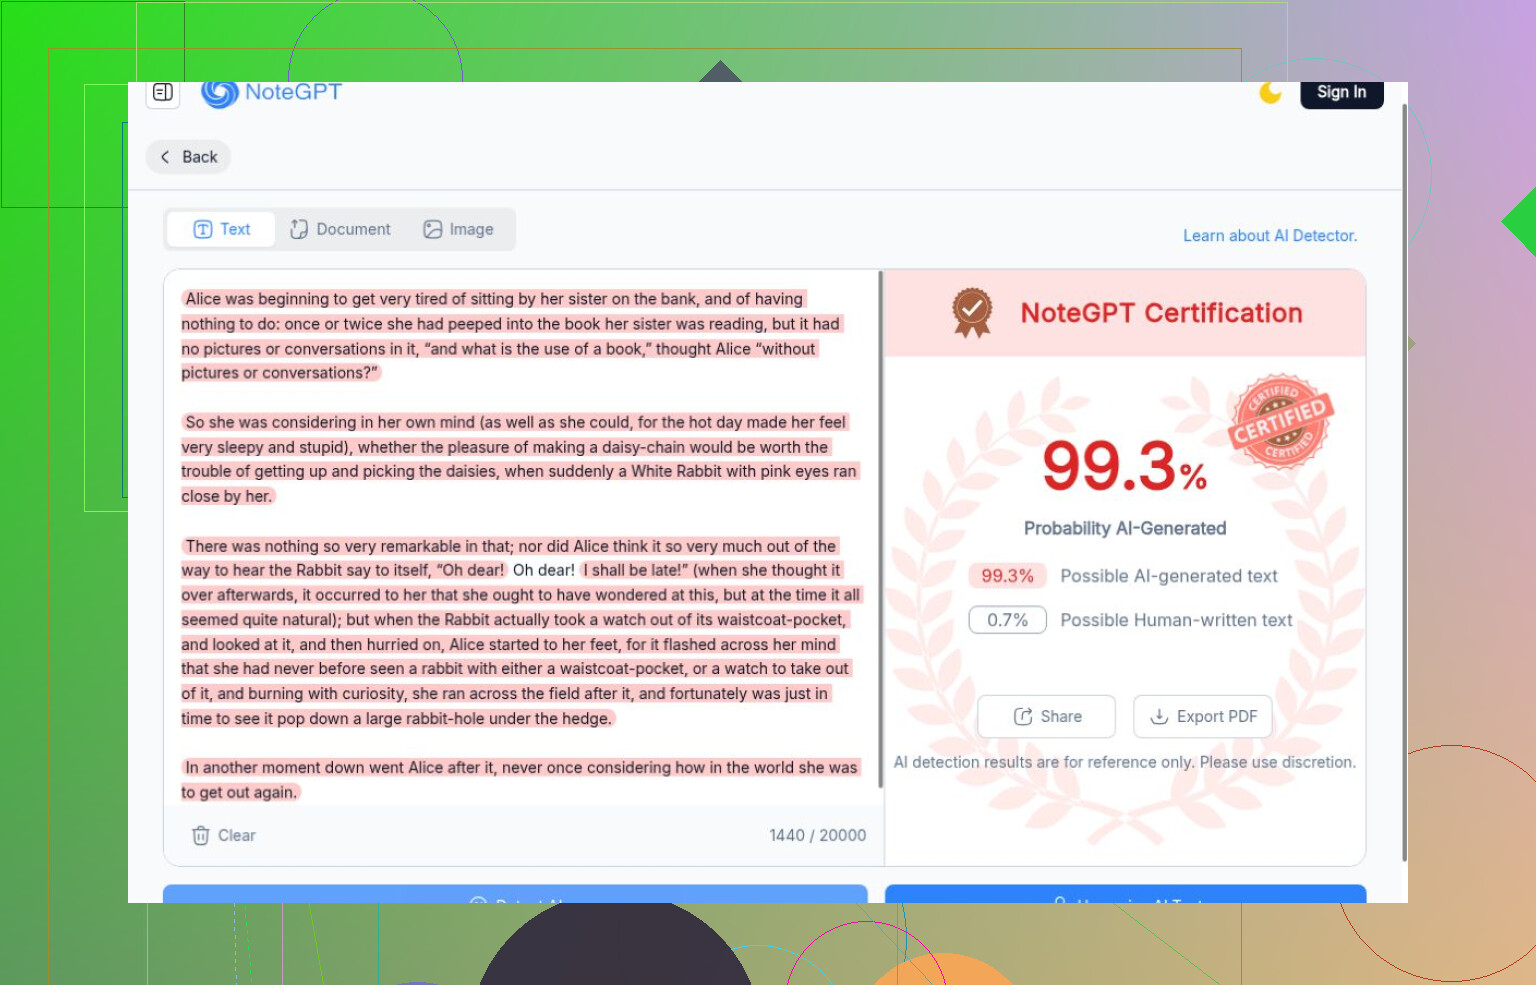
Empecé por los errores en material de origen conocido. ZeroGPT y NoteGPT asignaron a Carroll sus puntuaciones de IA más altas, incluida una del 99,3 %.
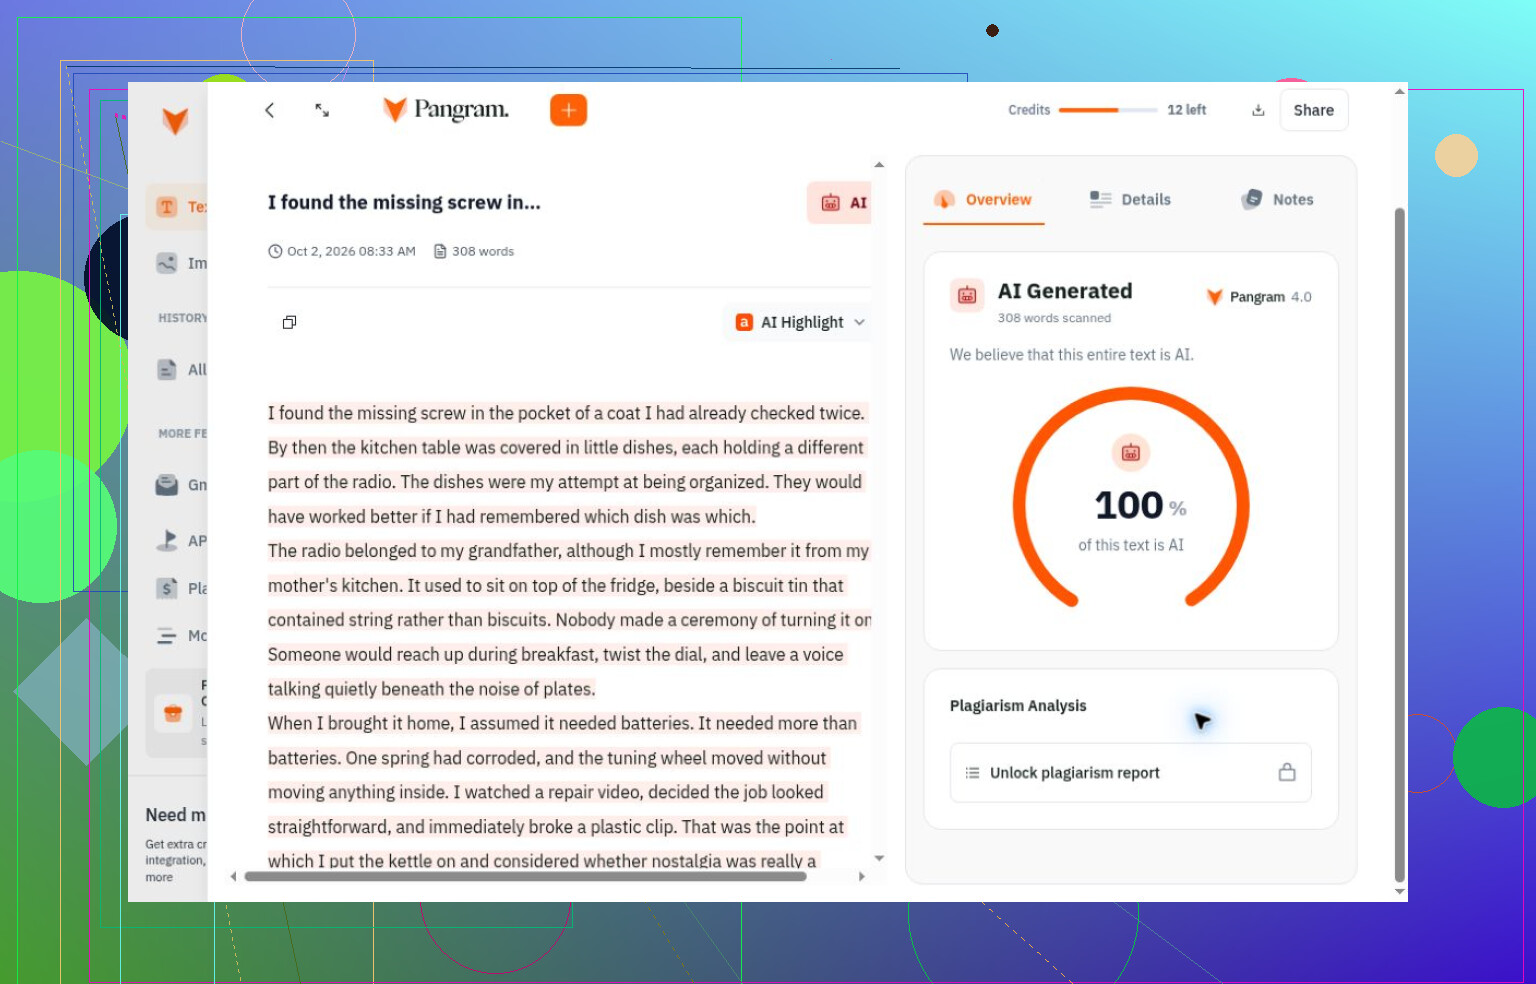
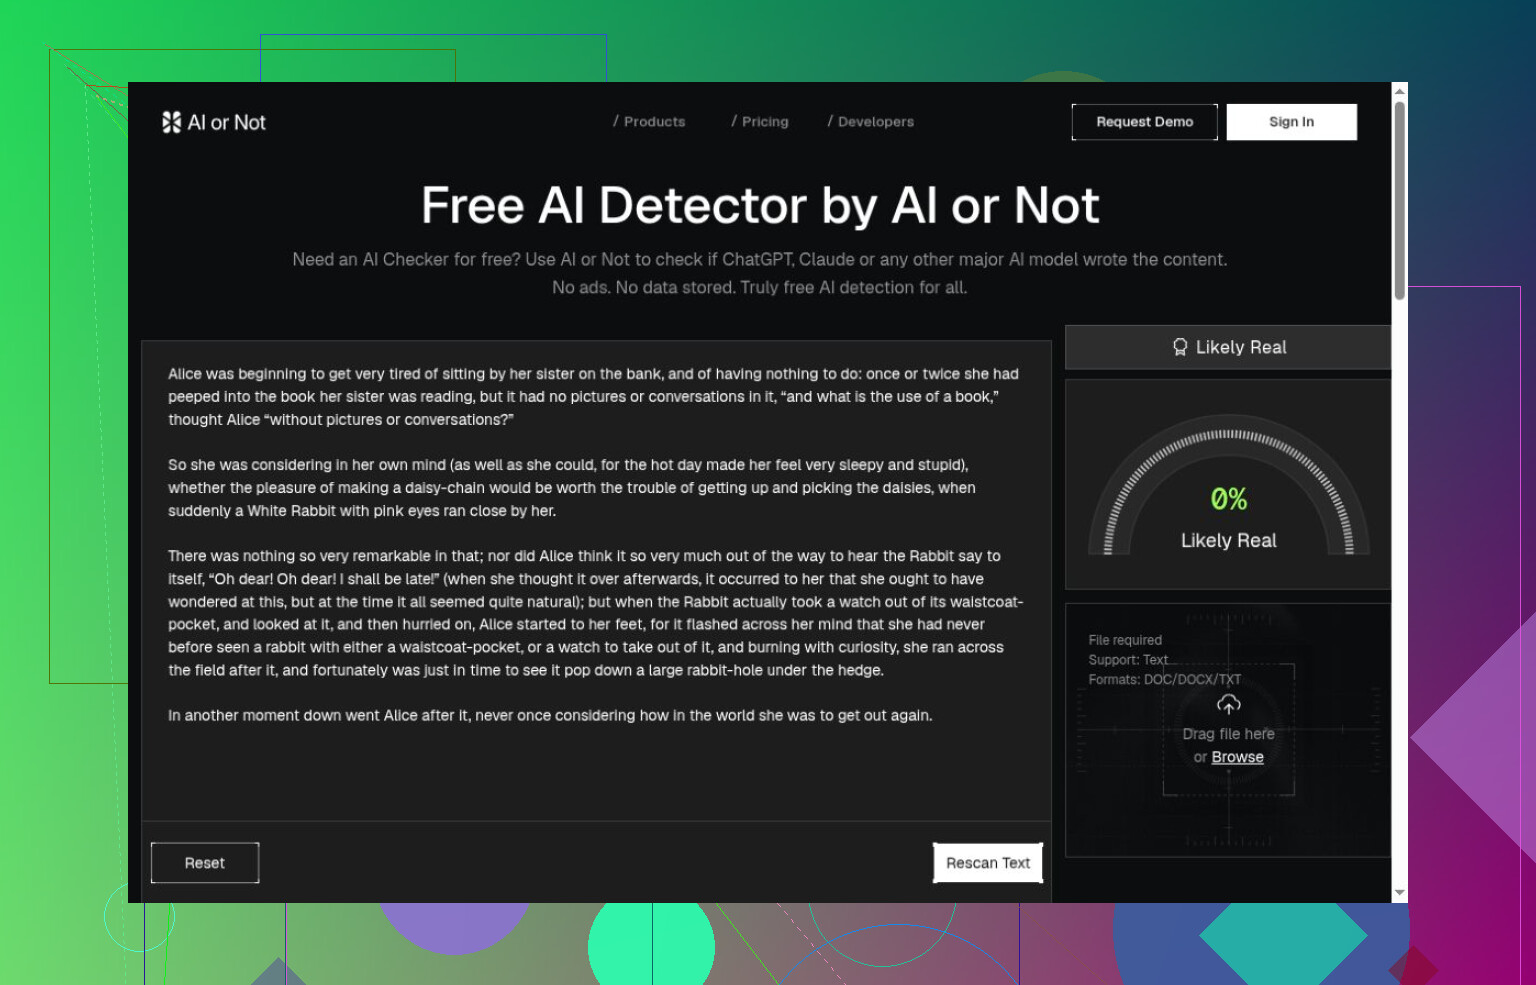
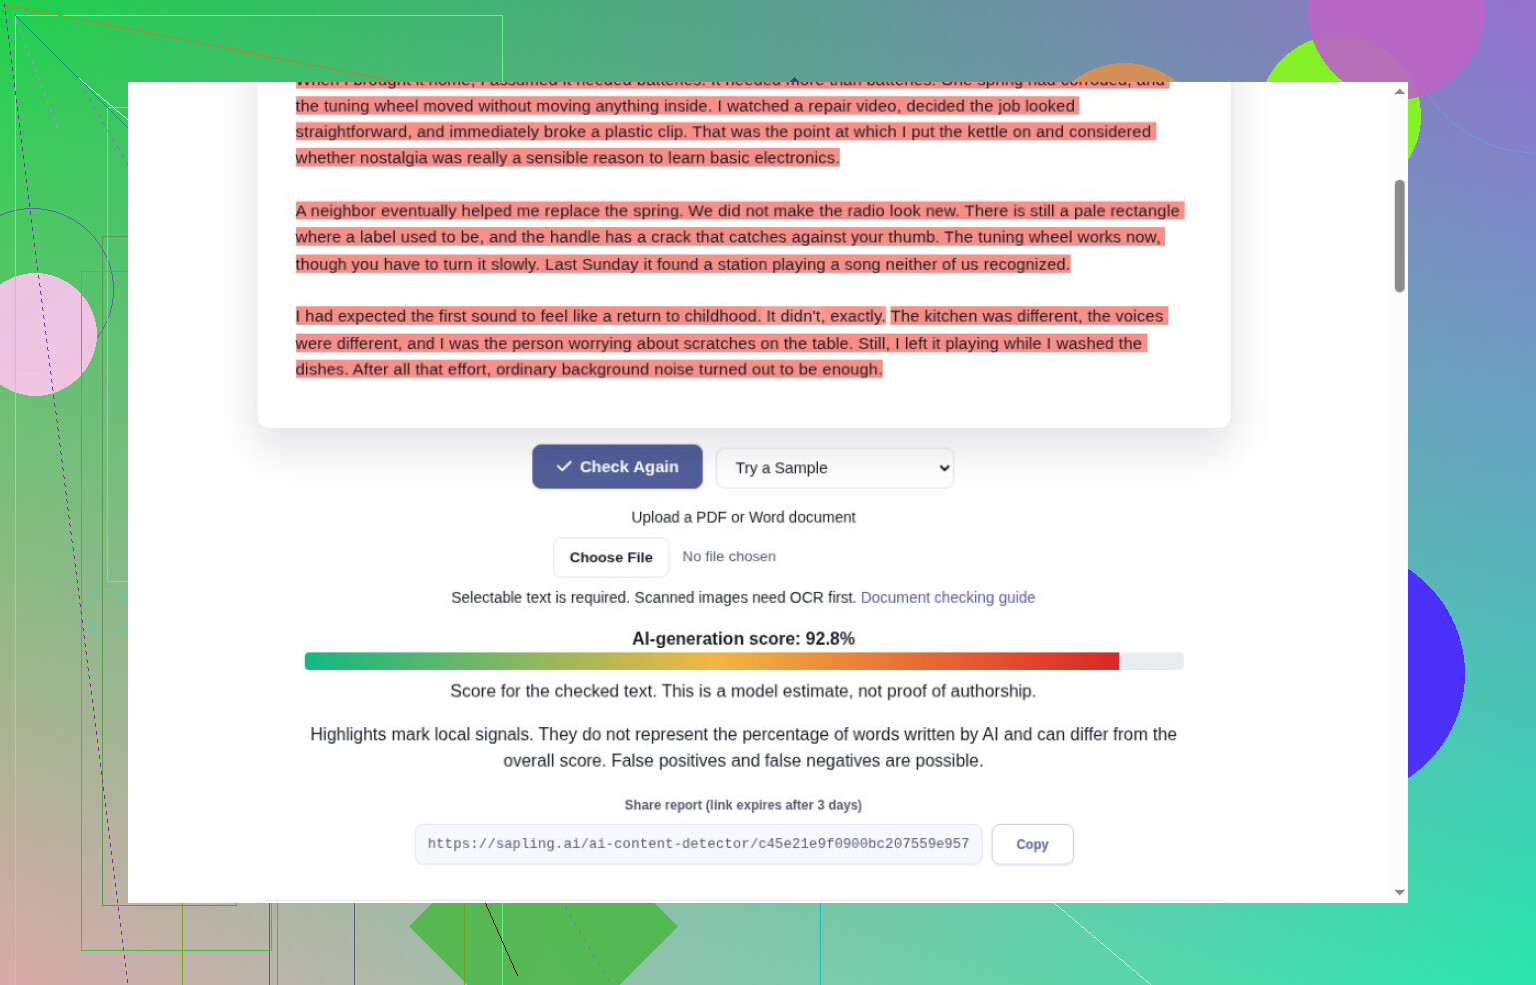
Pangram y AI or Not clasificaron correctamente los textos de control generados y humanos en las pruebas que completaron. La comprobación del ensayo con Sapling quedó truncada.
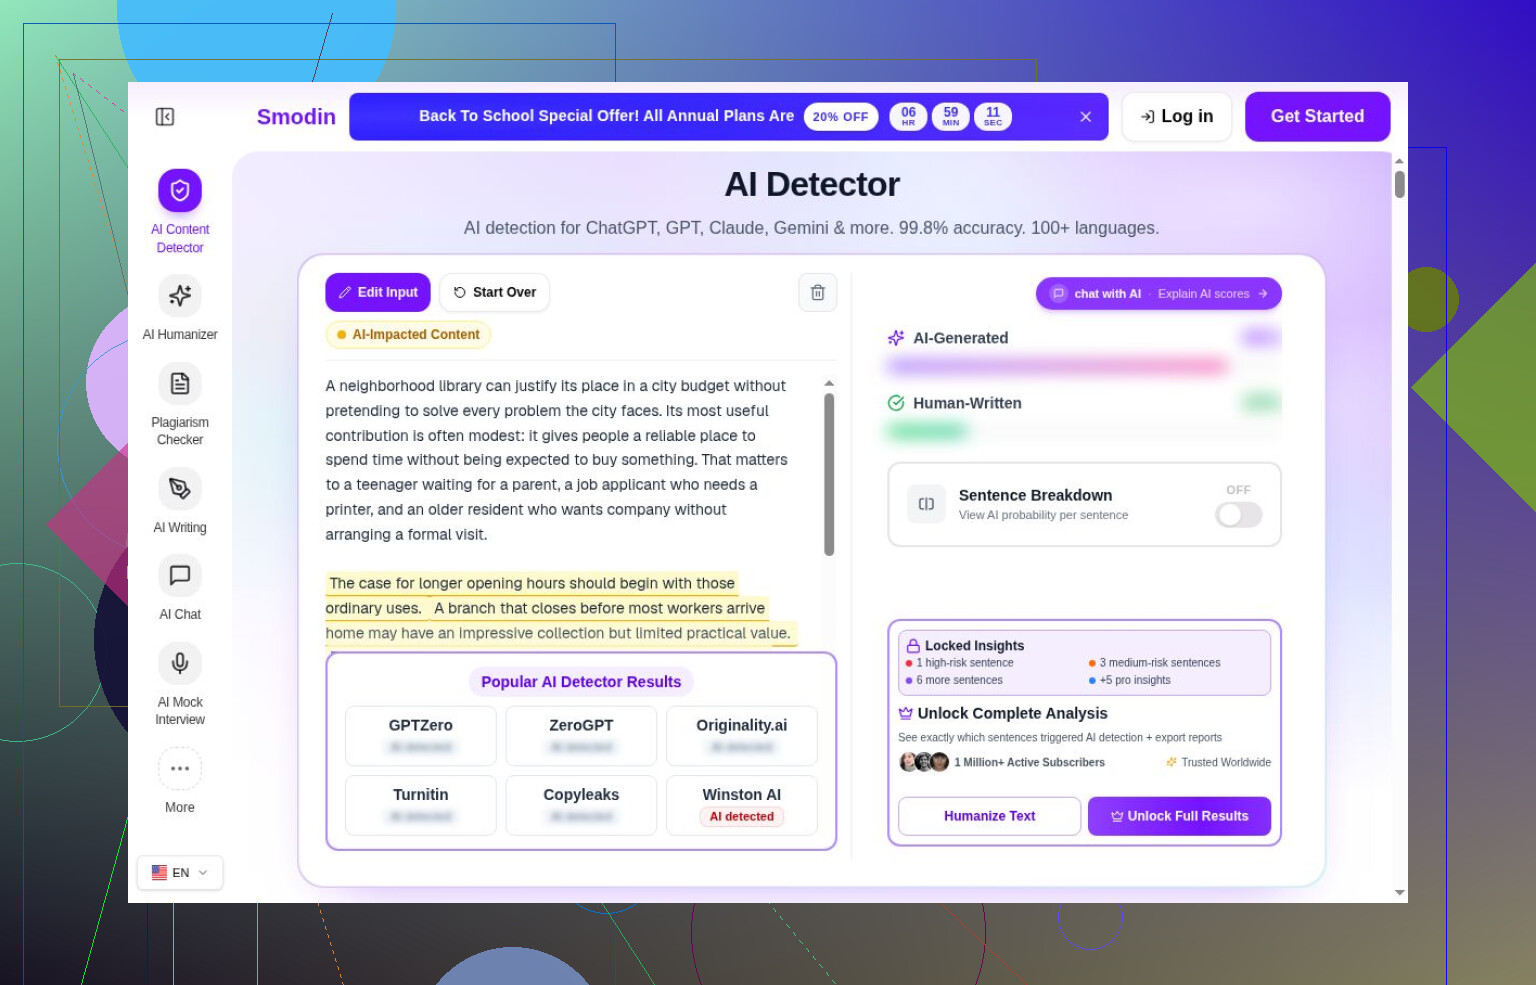
Registré por separado la solicitud de inicio de sesión de Decopy, los valores ocultos de Smodin y las pantallas de registro de AI Detector Pro y Winston.
Las condiciones de Copyleaks, los requisitos institucionales de Turnitin, la página de la extensión de Hive y la ficha de Humanly también documentaban el acceso, no el rendimiento de detección.
Ampliar los textos de control antes de sacar conclusiones
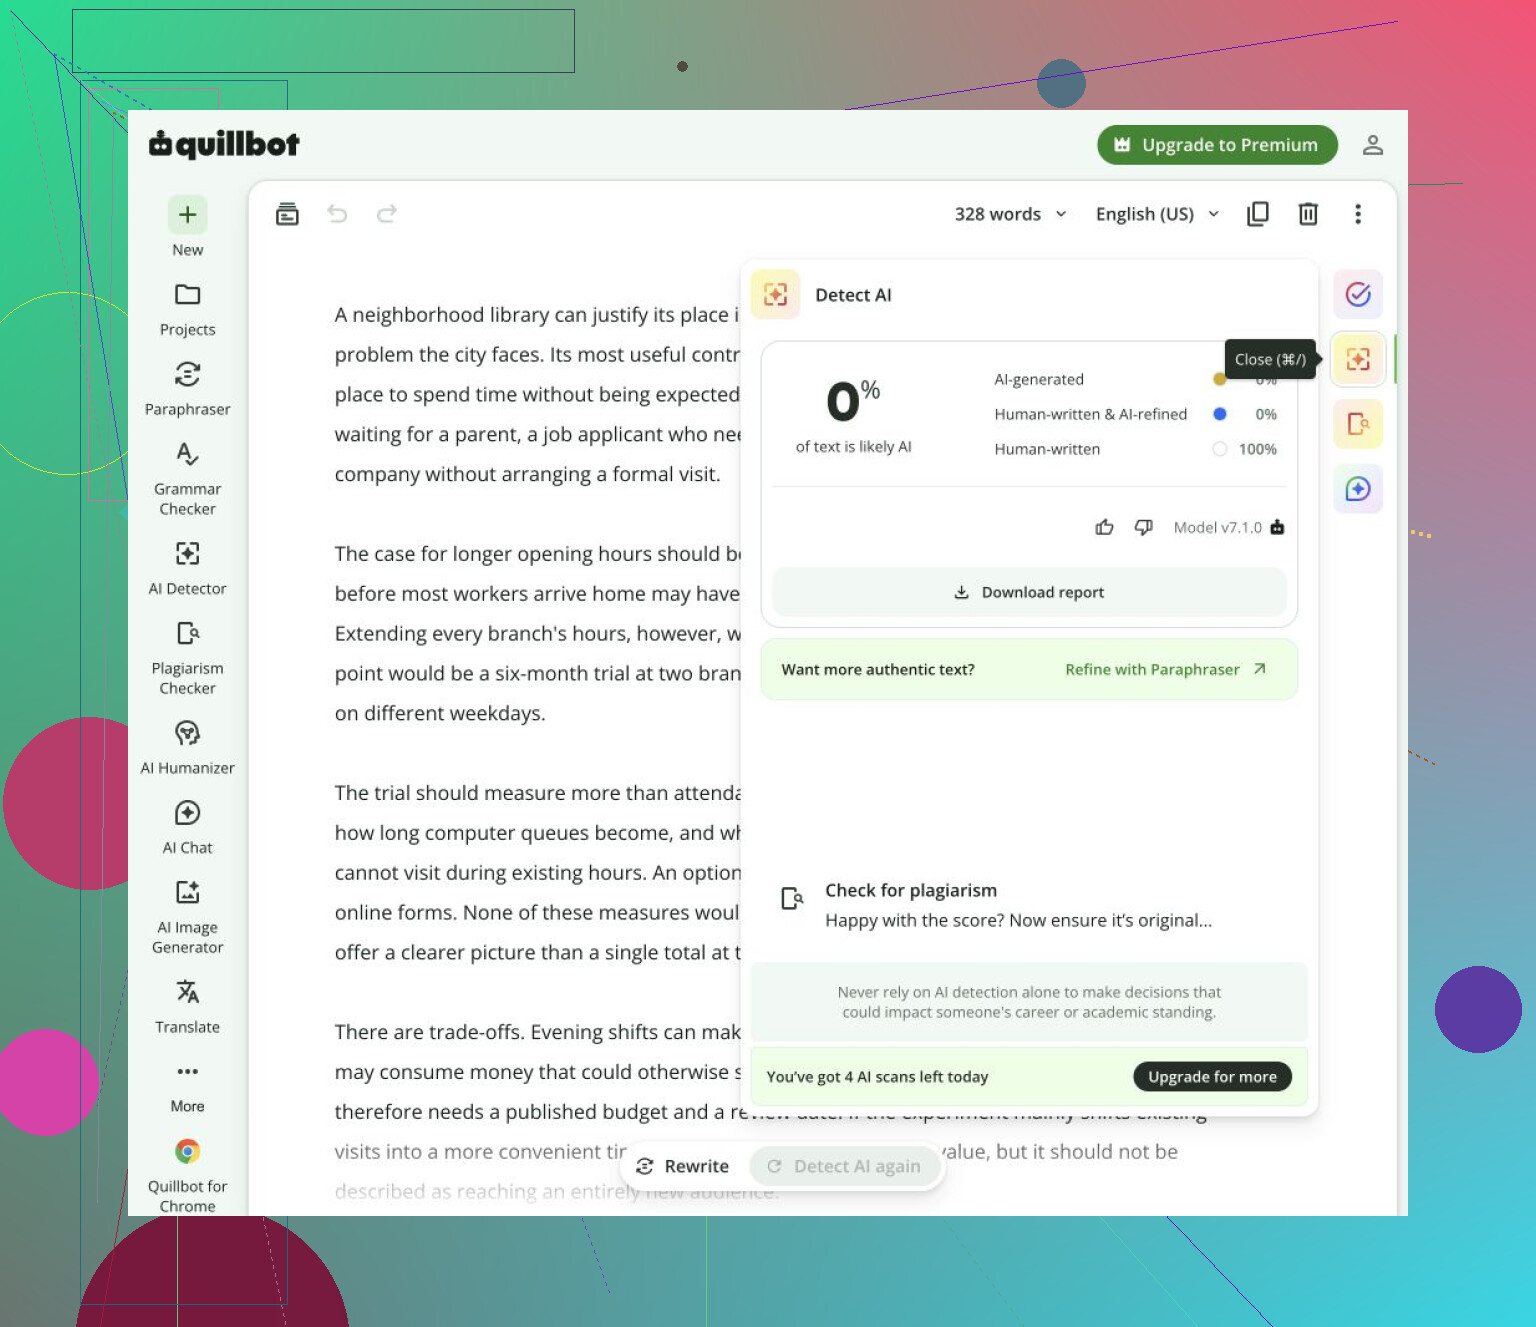
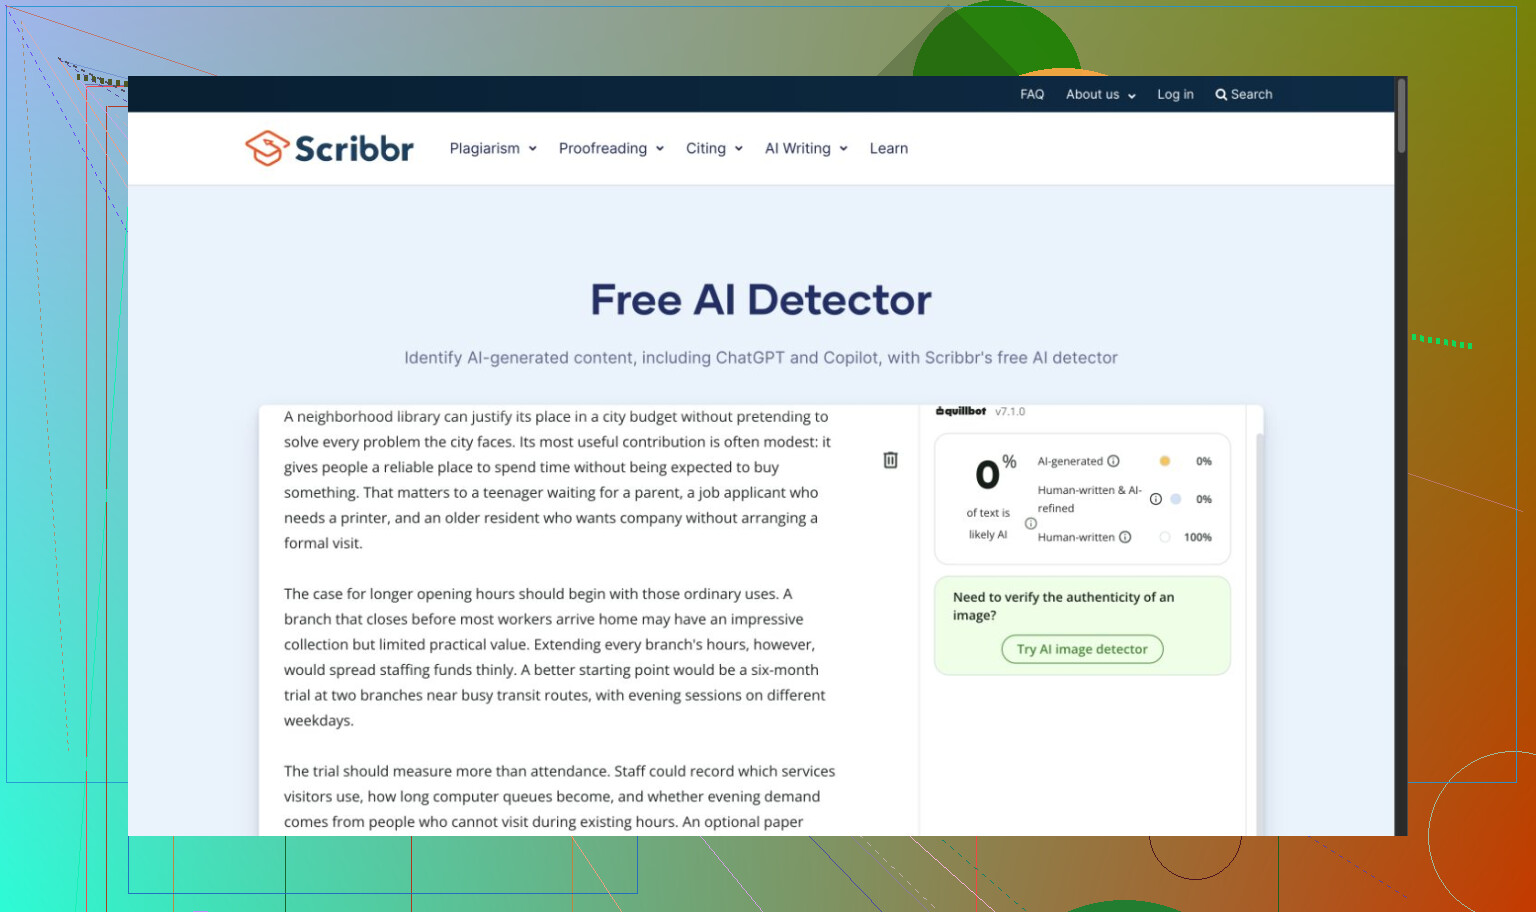
Clever detectó los fragmentos generados y aceptó el de Carroll, pero también clasificó como humana la versión ligeramente editada. No trataría ese fragmento mixto como otro texto humano de control sin modificar.
Para una prueba posterior, ampliaría las muestras de escritura humana antes de añadir más detectores. También conservaría el texto enviado, verificaría que cada resultado mostrado correspondiera al nuevo envío y excluiría los intentos sin terminar. La puntuación anterior que GPTZero seguía mostrando en pantalla hizo necesaria esa última distinción.
¿Qué muestras de escritura humana añadirías primero para que la próxima comparación fuera más informativa?
No reescribas las instrucciones de la impresora que ya funcionan para complacer a Copyleaks. No quiero que «selecciona la impresora, abre Propiedades, elige la impresión a doble cara» suene sofisticado. Significa que alguien sabe exactamente qué tiene que hacer para enviar un documento a la impresora. Mi objetivo era guiar a mi compañero por el proceso sin tener que estar a su lado todo el tiempo.
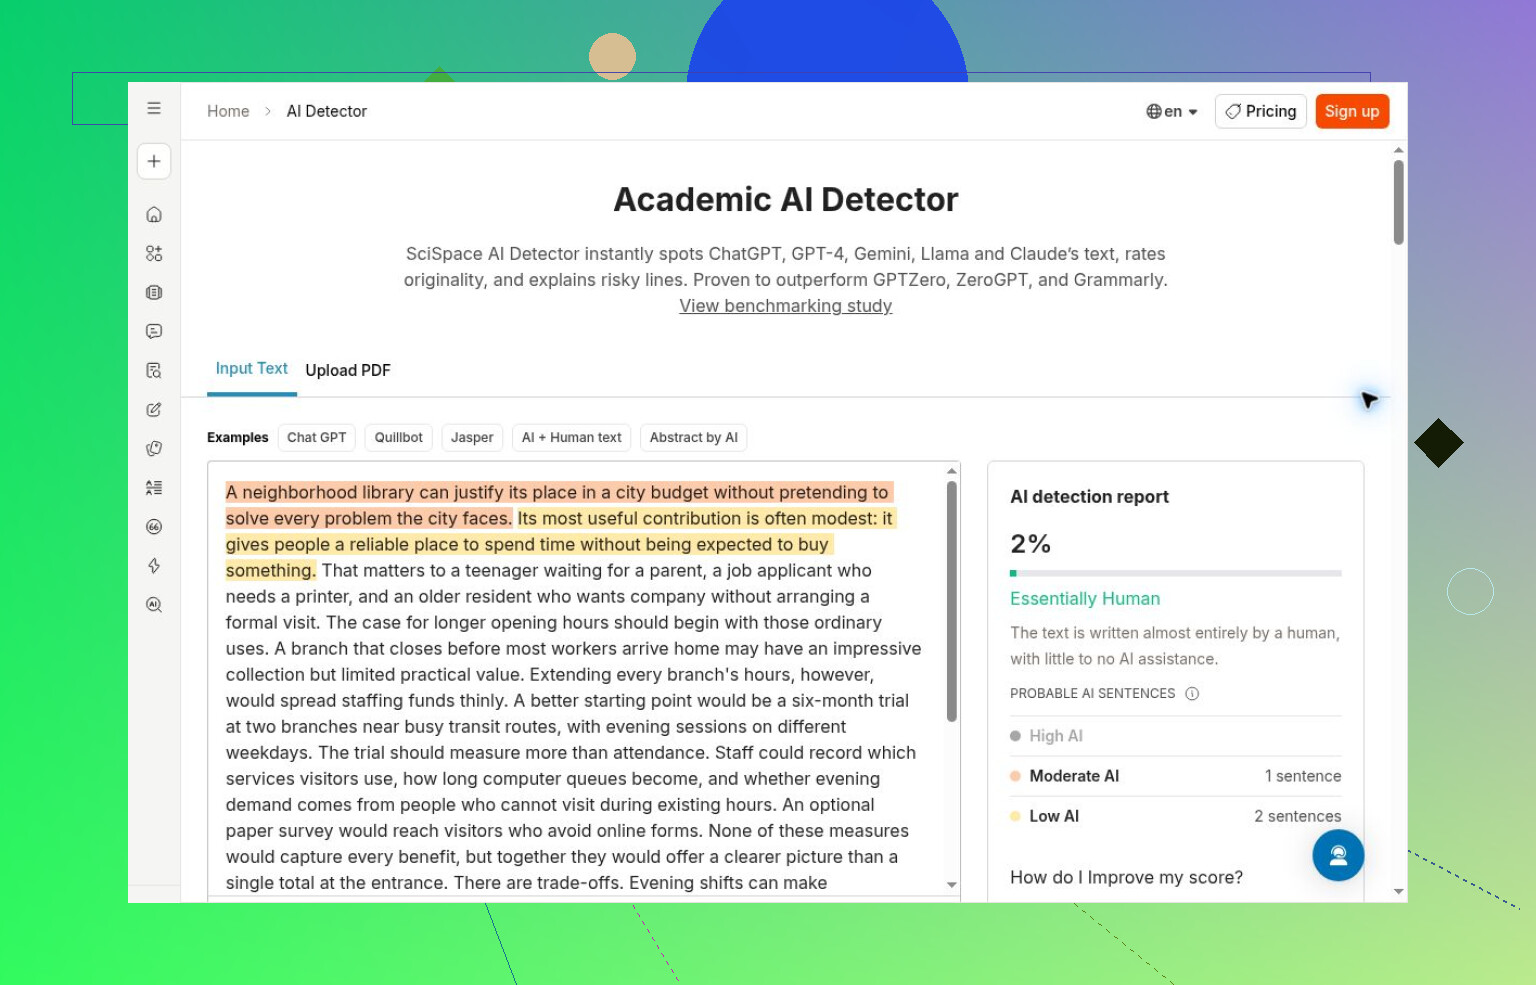
Para la próxima comparación de @0xbit1, daría prioridad a las listas de verificación y las notas de resolución de problemas escritas por personas frente a los fragmentos más literarios. Elige documentos con un historial de redacción rastreable y presenta los resultados de los textos de instrucciones por separado de los ensayos. Eso respondería a una pregunta más pertinente aquí: ¿confiarías en este detector para evaluar un documento de oficina corriente? Recomendaría la función de resaltado de frases de Clever AI Detector para esa comparación. Mostrar las frases concretas que resultan sospechosas es una función realmente útil para la revisión. (cleverhumanizer.ai)
Después, pon a prueba esas frases señaladas con un enfoque distinto. Pídele a una persona que siga exactamente las instrucciones que has preparado sin ninguna orientación y observa si se confunde. Si es así, vuelve a la instrucción y reformúlala. Y, a menos que esta prueba dé un mejor resultado, no cambiaría lo que claramente es una buena instrucción solo para obtener una respuesta distinta del detector.
Si la próxima comparación pretende representar la redacción de documentos de oficina, un borrador escrito desde cero no debería ser el único tipo de muestra de control de autoría humana. Me gustaría incluir una categoría para documentos que las personas elaboran a partir de material existente escrito por humanos. Eso plantea una cuestión distinta de si un detector puede distinguir un ensayo original de un texto generado.
Piensa en una guía de uso de una impresora adaptada de la guía de la oficina anterior. Alguien conserva las instrucciones básicas, cambia el nombre de la cola de impresión, elimina un paso obsoleto y añade una advertencia sobre la bandeja de papel. No interviene ninguna IA, pero tampoco sería exacto decir que esa persona ha escrito cada frase desde cero. La prueba debe dar cabida a ese caso sin tratar la reutilización como prueba de generación.
@0xbit1, lo primero que añadiría sería una lista de verificación reutilizable para la incorporación de personal, una respuesta de soporte adaptada de una respuesta guardada y un procedimiento revisado por varios compañeros de trabajo. Para esta categoría, elegiría material de origen cuya autoría humana se pueda demostrar. De lo contrario, una plantilla de origen desconocido introduce otra incertidumbre antes incluso de que intervenga el detector. Mantendría estos documentos separados tanto de los borradores escritos desde cero como de los fragmentos editados con IA.
Usaría Copyleaks y Clever AI Detector con ese conjunto. La comparación que me interesaría sería la del documento original escrito por una persona frente a su versión revisada también por una persona. ¿Cambia el veredicto después de que alguien actualice las instrucciones para otro lugar de trabajo? Si cambia, eso no nos diría por qué, pero permitiría identificar un caso de fallo que valdría la pena investigar. No hace falta convertirlo en una competición para ver qué herramienta gana en general.
En cuanto a la revisión del documento sobre la impresora, distinguiría entre «la sección señalada contiene formulaciones tomadas de una fuente» y «la sección señalada fue generada». Son afirmaciones distintas. Tus notas pueden ayudar a explicar cómo se elaboró el documento, incluidas las estructuras tomadas de otras fuentes o las formulaciones estándar. Me parecería más útil una revisión que mostrara si el veredicto de Copyleaks ayudó a resolver esa cuestión de autoría, en lugar de dejar que quien redactó el documento tenga que justificar una edición normal como si fuera sospechosa.
Comprueba que cada veredicto abarque todo el texto enviado antes de comparar las puntuaciones. Clever AI Detector se lleva mi voto por sus comparaciones de pasajes completos en tu comparativa, mientras que el intento de Sapling quedó truncado. Un veredicto sobre media guía no debería ponerse junto a un resultado sobre el documento completo como si ambos respondieran a la misma pregunta.
Evita elegir el resultado del análisis que mejor coincida con lo que esperabas. Al leer las sugerencias para hacer más comparaciones, me quedé pensando en algo más sencillo: si envías una guía, cambias su formato y vuelves a enviarla, ¿qué resultado acaba apareciendo en la reseña? Me gustaría ver el primer intento, aunque un resultado posterior parezca más creíble.
Para mí, esos resultados responderían a preguntas distintas. El envío original muestra lo que ocurrió cuando analizaste tu documento de la forma habitual. Una prueba posterior, sin los encabezados o con los pasos numerados convertidos en párrafos, serviría para explorar si la presentación afecta al veredicto. Si la clasificación cambiara, no sabría qué cambio de formato lo provocó sin hacer más pruebas, pero no consideraría el resultado más favorable como una prueba de que el detector ahora entendía el texto.
Ahí es donde me convence menos la idea de que el siguiente paso deba ser añadir más herramientas. Las notas que guardaste te dan algo con lo que contrastar la afirmación sobre la autoría. Mantener el primer análisis separado de cualquier experimento haría que la reseña fuera más fácil de seguir para alguien principiante como yo: esto es lo que indicó Copyleaks y esto es lo que ocurrió solo después de que empezaras a modificar el documento enviado.
Analiza un fragmento corto como ‘abre Propiedades, elige impresión a doble cara’ por separado y la mayoría de los detectores se desorientan, pero pega la guía completa y esa misma redacción suele parecer humana. Esta sensibilidad a la longitud es algo que conviene tener en cuenta en tu reseña de la impresora. Los textos de instrucciones son breves y repetitivos por naturaleza, un tipo de texto que estas herramientas suelen interpretar mal, así que un veredicto sobre una sola sección resaltada tiene menos peso del que parece.
Coincido con @cyberpilotzone en distinguir la reutilización de la generación; esa es la verdadera trampa aquí. Un texto estándar reutilizado de una antigua guía de oficina parecerá ‘no humano’ para muchos de estos modelos sin que haya intervenido ni una sola instrucción a una IA. Las notas que has guardado valen más que cualquier puntuación para aclarar eso.
En cuanto a la herramienta en sí, me gusta que Clever AI Detector analice rápidamente los bloques de texto pegados y no se haga un lío con mis pasos numerados cuando los introduzco, algo importante cuando el formato es la mitad de lo que importa. Yo habría analizado la guía completa, sin recortarla para dejar solo la parte señalada, antes de sacar conclusiones de la puntuación.
No envíes la guía de la oficina a más detectores sin comprobar qué estás compartiendo. La insistencia en hacer comparaciones más amplias pasa por alto una pregunta básica: ¿contiene el documento detalles de la red interna, códigos de acceso o información de empleados que no deberías subir? Si eliminas esos datos para realizar pruebas, indica ese cambio en la reseña en lugar de tratar la copia editada como si fuera el documento original enviado.
Un falso positivo podría generar más trabajo del que se pretendía ahorrar con la investigación sobre la copia de la guía. Tus notas han ayudado a salvar este caso, pero tiendo a ser escéptico ante cualquier flujo de trabajo que exija a los usuarios disponer de un historial de redacción para poder defenderse por unas simples instrucciones de impresora. Consideraría el tiempo dedicado a investigar esa alerta como un coste en la evaluación de Copyleaks, aunque el análisis haya sido rápido.
Pregunta al soporte de Copyleaks cómo se supone que puedes impugnar esa alerta sin subir más material de la oficina. Lo que comenta @corelabedge sobre el trabajo extra es la razón por la que incluiría su respuesta en la reseña. «Vuelve a analizarlo» y «así investigamos un posible error» me dejarían opiniones muy distintas sobre el servicio.